

Что такое статистическая обработка данных
Статистическая обработка – это совокупность методов, которые позволяют упорядочить, описать и проанализировать собранные данные, чтобы выявить закономерности и проверить гипотезы. Если коротко, это путь от набора наблюдений к обоснованным выводам.
Обычно статистическая обработка решает четыре задачи:
- Описать данные. Посчитать средние значения, доли, разброс.
- Найти закономерности. Выявить связи между показателями и различия между группами.
- Проверить гипотезы. Выяснить, случайна ли разница или она значима.
- Спрогнозировать. Оценить, как показатель поведёт себя дальше.
Первичные статистические данные: что это
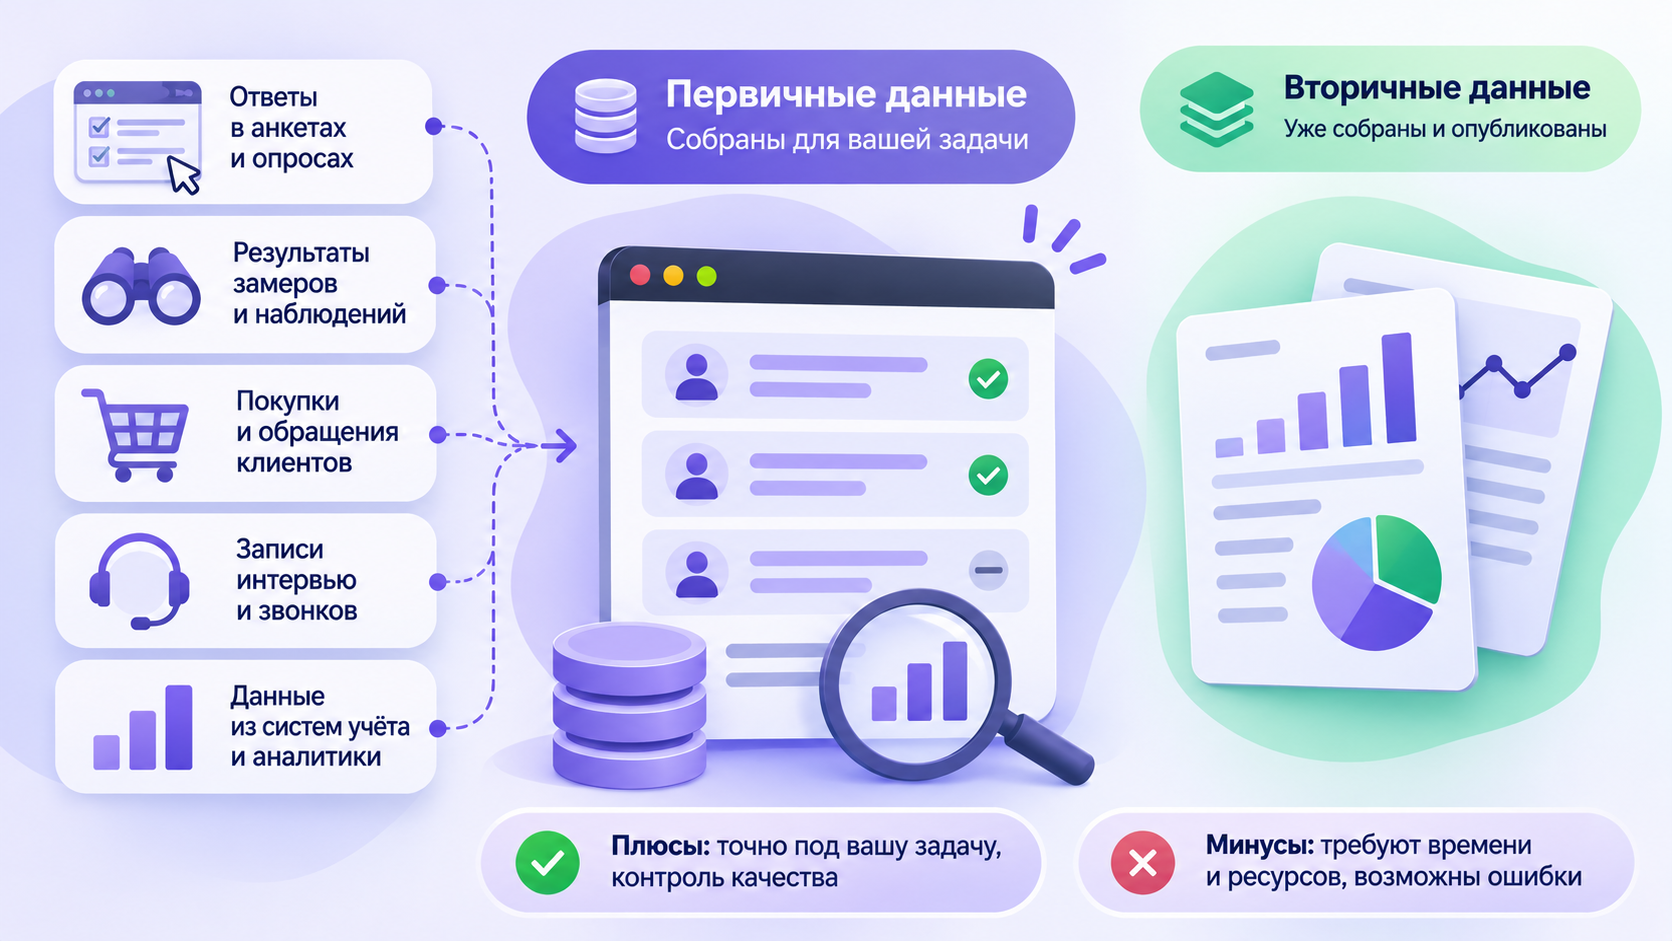
Первичные статистические данные – это информация, которую собрали напрямую, для конкретной задачи, и ещё не обработали. Это «сырьё» исследования. Например:
- ответы респондентов в анкете, форме или опросе;
- результаты замеров и наблюдений;
- данные о покупках и обращениях клиентов;
- записи интервью и звонков;
- показатели из систем учёта и аналитики.
Их противопоставляют вторичным данным: это уже собранные и опубликованные кем-то материалы, например отраслевые отчёты, статистика ведомств, чужие исследования.
Главное достоинство первичных данных в том, что они точно соответствуют вашей задаче, вы знаете, как их собирали, и можете контролировать качество. Недостаток в том, что сбор требует времени и ресурсов, а в «сырых» данных часто есть ошибки, пропуски и дубли.
Где собирать первичные данные: формы, опросы и квизы
Самый доступный способ получить первичные данные – онлайн-формы. Клиент или респондент сам вводит информацию, а вы сразу получаете её в структурированном виде. Чаще всего для этого используют:
- анкеты и опросы для исследований и обратной связи;
- формы заявок и регистрации на сайте или лендинге;
- квизы, где человек проходит серию вопросов и получает результат или расчёт, а вы получаете его ответы и контакты;
- формы обратной связи после покупки или обращения.
От того, как устроена форма, зависит качество будущей статистики. Если поле «телефон» принимает любой текст, а вопрос о возрасте не имеет ограничений, на этапе очистки придётся исправлять десятки записей вручную. Если в вопросе нет единой шкалы, ответы нельзя сравнить.
Для создания таких форм используют конструкторы. В контексте сбора данных они помогают решить несколько практических задач:
- собрать ответы в структурированном виде, а не в хаотичных сообщениях и письмах;
- задать тип вопроса (выбор варианта, шкала, открытый ответ), чтобы данные приходили в одном формате;
- сделать обязательные поля и проверку, чтобы снизить число пропусков и ошибок;
- встроить форму или квиз на сайт для получения заявок и ответов в одном месте;
- использовать квиз как инструмент, который одновременно вовлекает посетителя и собирает данные о его потребностях.
Так этап сбора превращается в часть общего процесса: корректные данные на входе означают меньше времени на первичную обработку и более надёжные выводы.
Первичная обработка статистических данных
Прежде чем применять сложные методы, данные нужно привести в порядок. Если собирать ответы вручную (в таблицах, мессенджерах, письмах), приходится делать много рутины: искать пропуски, исправлять форматы, сводить ответы в таблицы и считать, сколько человек выбрало каждый вариант.
Конструктор форм убирает большую часть этой работы ещё на этапе сбора:
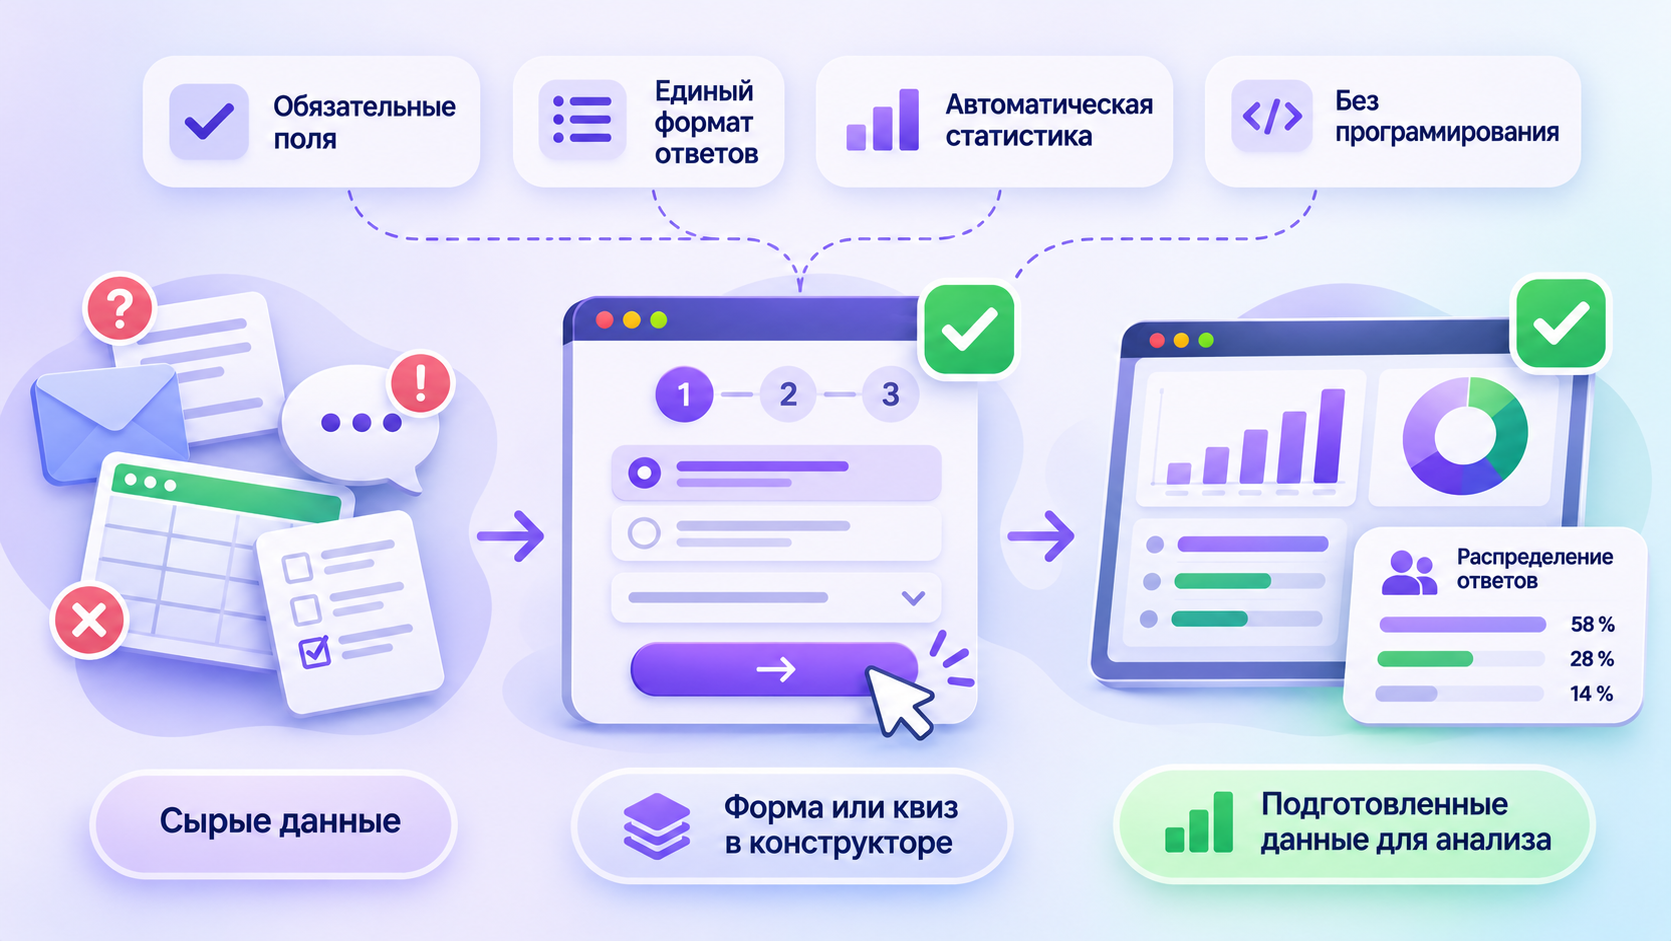
- Пропусков не будет. Важные вопросы достаточно сделать обязательными, и форму нельзя отправить, пока они не заполнены.
- Ответы приходят в едином виде. Если человек выбирает вариант из списка, а не пишет своими словами, не нужно приводить написания к одному формату.
- Подсчёт делать не нужно. Во встроенной статистике сразу видно, сколько респондентов выбрали каждый вариант и как распределились ответы.
- Не нужны навыки программирования. Форму и квиз собирают из готовых блоков, без кода.
Так «сырые» данные превращаются в готовую сводку без лишних шагов. Вручную остаётся проверить то, что не поймает ни одна форма: странные ответы в открытых полях, явно случайные значения и повторные заявки от одного человека.
Первичный анализ данных
После сбора наступает этап, который называют первичным анализом данных. Его цель простая: понять, что вообще есть в ответах, прежде чем проверять сложные гипотезы.
Раньше для этого приходилось выгружать ответы в таблицу и считать вручную. Если данные собраны в конструкторе, базовую картину показывает встроенная статистика:
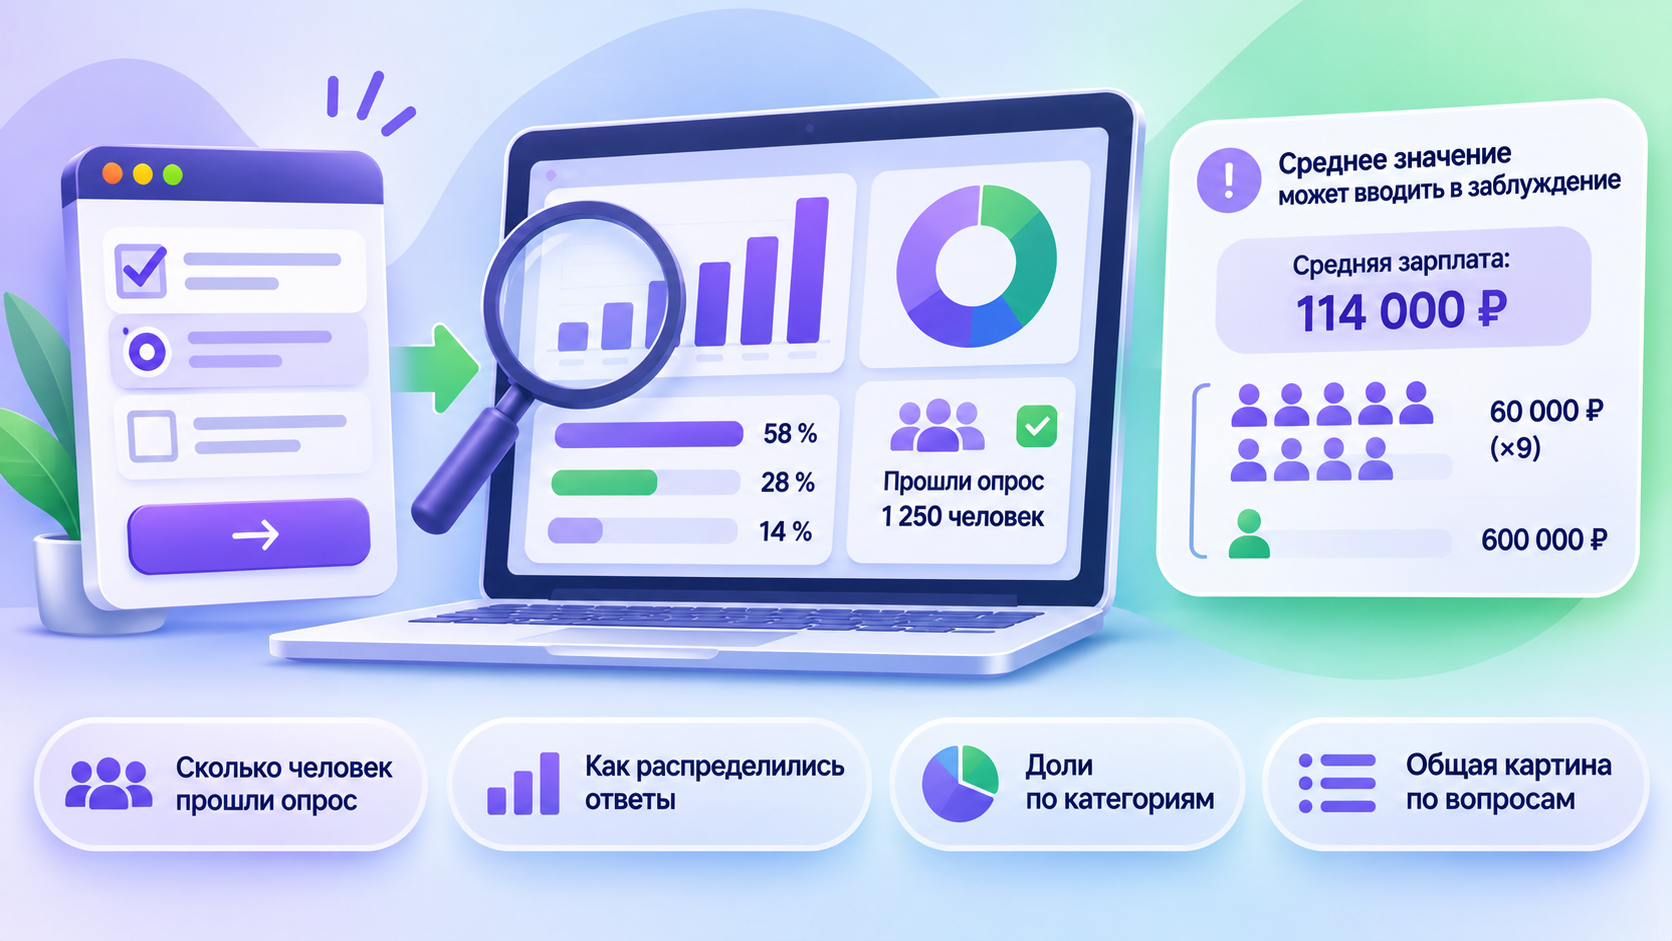
- сколько человек прошли опрос или квиз и сколько дошли до конца;
- как распределились ответы: какой вариант выбирали чаще всего, а какой почти не выбирали;
- доли по категориям: например, какой процент респондентов назвал главной проблемой цену, а какой – сроки;
- общую картину по вопросам без сводных таблиц и формул.
Этого достаточно для большинства практических задач: понять, чего хочет аудитория, какие варианты популярны, где респонденты бросают анкету.
Один нюанс остаётся актуальным и при готовой статистике: среднее значение легко обмануть. Если в выборке из десяти сотрудников девять получают 60 тысяч, а один 600 тысяч, средняя зарплата составит 114 тысяч, хотя ни у кого из девяти она не близка к этой цифре. Поэтому при числовых ответах (бюджет, возраст, стаж) смотрите не только на среднее, но и на то, как распределились значения.
Статистическая обработка результатов: основные методы
Для большинства задач бизнеса хватает простого подсчёта: кто что выбрал и в каком соотношении. Статистическая обработка результатов в полном смысле нужна, когда требуется ответить на более глубокие вопросы:
- отличаются ли две группы клиентов (например, новые и постоянные) по своим ответам или это случайность;
- связаны ли между собой два показателя, например размер бюджета и срочность задачи;
- можно ли распространить результаты опроса на всю аудиторию или выборка слишком мала;
- как будет вести себя показатель дальше (прогноз).
Для таких задач ответы выгружают из конструктора и считают в специальных инструментах:
| Задача | Метод | Где считать |
|---|---|---|
| Описать выборку | Частоты, доли, средние | Часто встроенная статистика конструктора |
| Сравнить две группы | t-критерий Стьюдента, критерий Манна – Уитни | Excel, Google Таблицы, SPSS |
| Сравнить несколько групп | Дисперсионный анализ (ANOVA) | SPSS, R, Python |
| Найти связь между показателями | Корреляционный анализ | Excel, R, Python |
| Проверить связь категорий | Критерий хи-квадрат | SPSS, R, Python |
| Прогнозировать значение | Регрессионный анализ | R, Python |
| Выделить типы респондентов | Кластерный и факторный анализ | SPSS, R, Python |
Если вы не исследователь, а владелец бизнеса или маркетолог, углубляться в эти методы обычно не нужно. Базовых цифр из встроенной статистики хватает, чтобы принимать решения, а сложный анализ стоит заказывать, когда на кону серьёзные расходы или масштабное исследование.
Основные принципы статистики
Методы можно освоить за пару недель, но без понимания основных принципов статистики выводы будут ненадёжными. Вот главные из них:
Репрезентативность выборки. Выборка должна отражать генеральную совокупность. Опрос только активных клиентов не покажет, почему остальные ушли.
Достаточный объём. Чем меньше наблюдений, тем выше погрешность. Выводы по десяти ответам нельзя переносить на всю аудиторию.
Случайность отбора. Если респонденты отбираются не случайно, а по удобству сбора, результат смещается.
Статистическая значимость. Различие между группами может быть случайным. Значимость показывает, насколько велика вероятность, что разница действительно существует.
Корреляция не равна причинности. Если два показателя растут вместе, это не значит, что один вызывает другой. Продажи мороженого и число утоплений растут летом, но причина общая: жара.
Единообразие сбора. Все респонденты должны отвечать на одни и те же вопросы в одинаковых условиях, иначе данные нельзя сравнивать. Именно поэтому для сбора удобнее использовать единую онлайн-форму, а не разрозненные переписки и таблицы.
Примеры вопросов для выявления потребностей
Качество статистики зависит от качества первичных данных, а они зависят от вопросов. Хорошо сформулированные вопросы дают данные, которые можно посчитать и сравнить. Ниже примеры вопросов для выявления потребностей клиентов, которые удобно оформить как анкету или квиз.
Про задачу и ситуацию:
- Какую задачу вы хотели решить, когда начали искать продукт?
- Как вы решаете её сейчас?
- Как часто вы сталкиваетесь с этой задачей? (ежедневно / еженедельно / ежемесячно / редко)
Про проблемы:
- Что в текущем решении вас не устраивает больше всего? (выберите до трёх вариантов)
- Какие трудности возникают на этом этапе?
- Что из перечисленного вызывает у вас наибольшее неудобство?
Про ожидания и приоритеты:
- Что для вас важнее всего при выборе? (цена / качество / скорость / сервис / гарантии)
- Оцените важность каждого критерия от 1 до 5.
- Какой результат вы считаете идеальным?
Про бюджет и сроки:
- Какой бюджет вы готовы выделить на решение этой задачи?
- В какие сроки вам нужен результат?
Про принятие решения:
- Кто ещё участвует в выборе?
- Что может помешать вам принять решение?
Несколько правил формулировки:
- Закрытые вопросы с вариантами ответа удобно обрабатывать, открытые дают глубину. Сочетайте оба типа.
- Избегайте наводящих формулировок вроде «Вам нравится наш сервис?».
- Используйте шкалы одного формата, чтобы ответы можно было сравнивать.
Такой набор вопросов можно собрать в конструкторе форм и разместить на сайте или распространить по ссылке или qr-коду. Ответы будут приходить уже структурированными, а значит, переходить к анализу можно быстрее.
Как собрать данные с помощью QForm
Для сбора первичных данных можно использовать конструктор форм и видеовиджетов QForm. В нём доступны текстовые и числовые поля, выбор одного или нескольких вариантов, выпадающие списки, шкалы, даты и другие типы вопросов, благодаря чему формат ответа можно подобрать под конкретную исследовательскую задачу. Обязательные поля, маски и ограничения заполнения помогают получить более однородный массив данных и сократить количество записей, которые позднее придётся исправлять вручную.
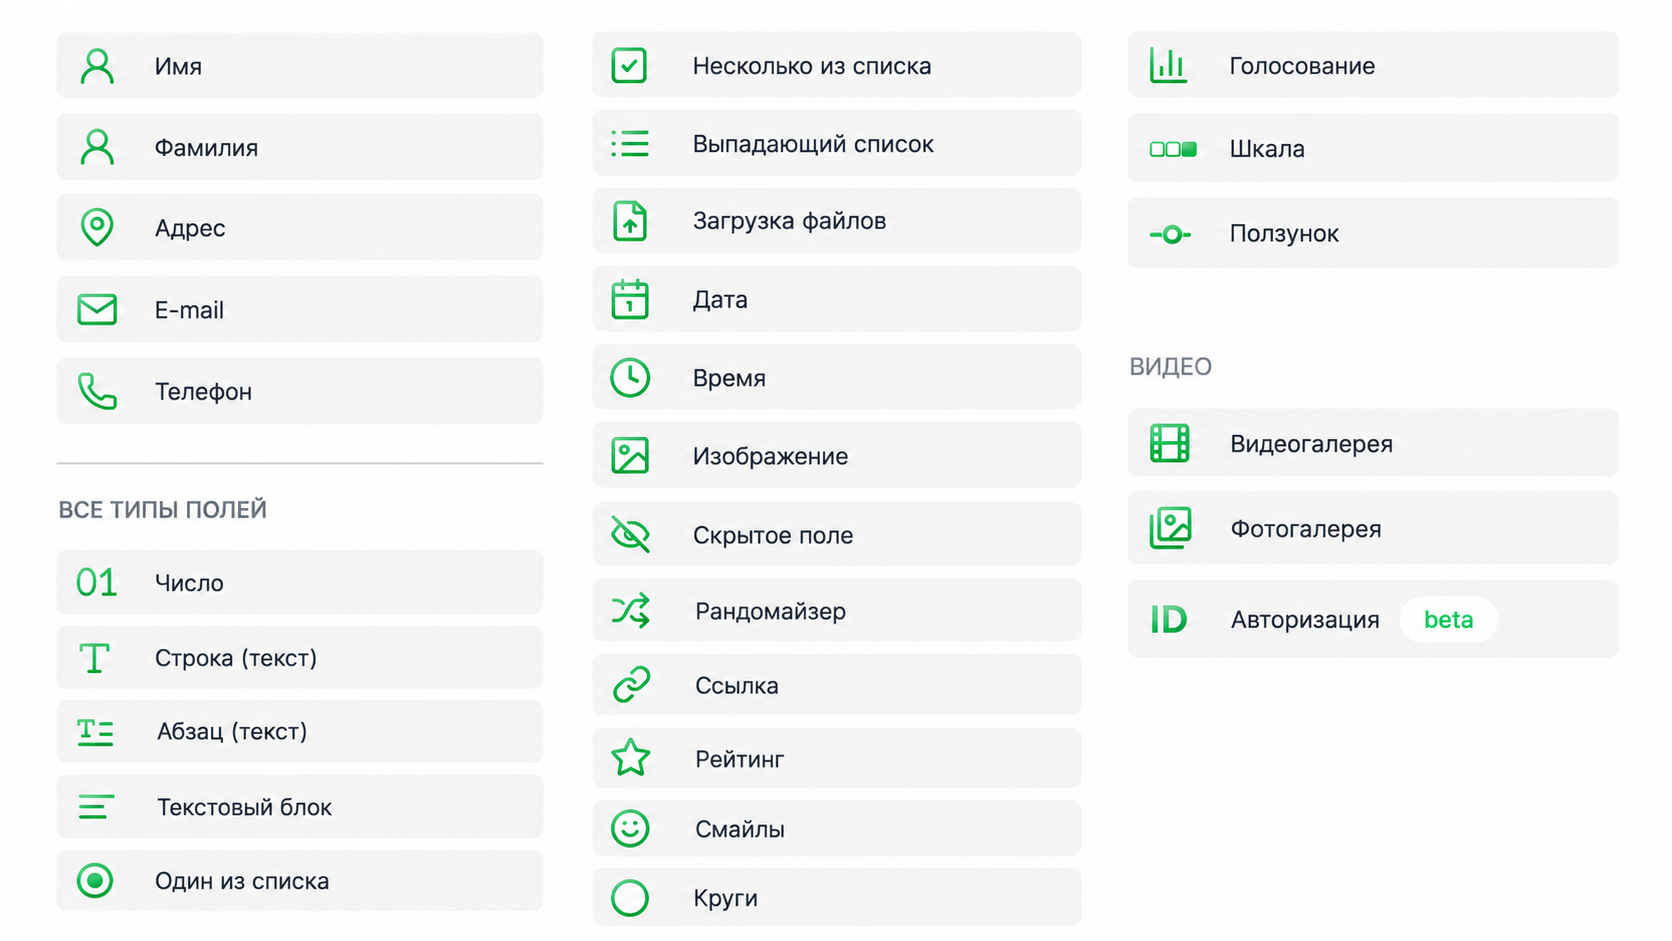
Если состав вопросов зависит от предыдущих ответов, форму можно построить с ветвлением и показывать респонденту только относящиеся к нему поля. Например, клиенту, который уже пользуется продуктом, задать вопросы об опыте и удовлетворённости, а человеку, отказавшемуся от покупки, предложить указать причины такого решения. В результате одна анкета подходит для нескольких групп аудитории, при этом ответы остаются структурированными и пригодными для дальнейшего сравнения.
Для первичного анализа не всегда требуется сразу выгружать массив в отдельную программу. В аналитике QForm можно посмотреть количество показов и отправок, конверсию, среднее время заполнения, а для полей с вариантами выбора увидеть распределение ответов по каждому вопросу. Данные фильтруются по периоду, что позволяет оценивать изменения без ручного сведения нескольких таблиц. Если требуется более сложная статистическая обработка, результаты можно выгрузить и продолжить работу с ними в подходящем аналитическом инструменте.
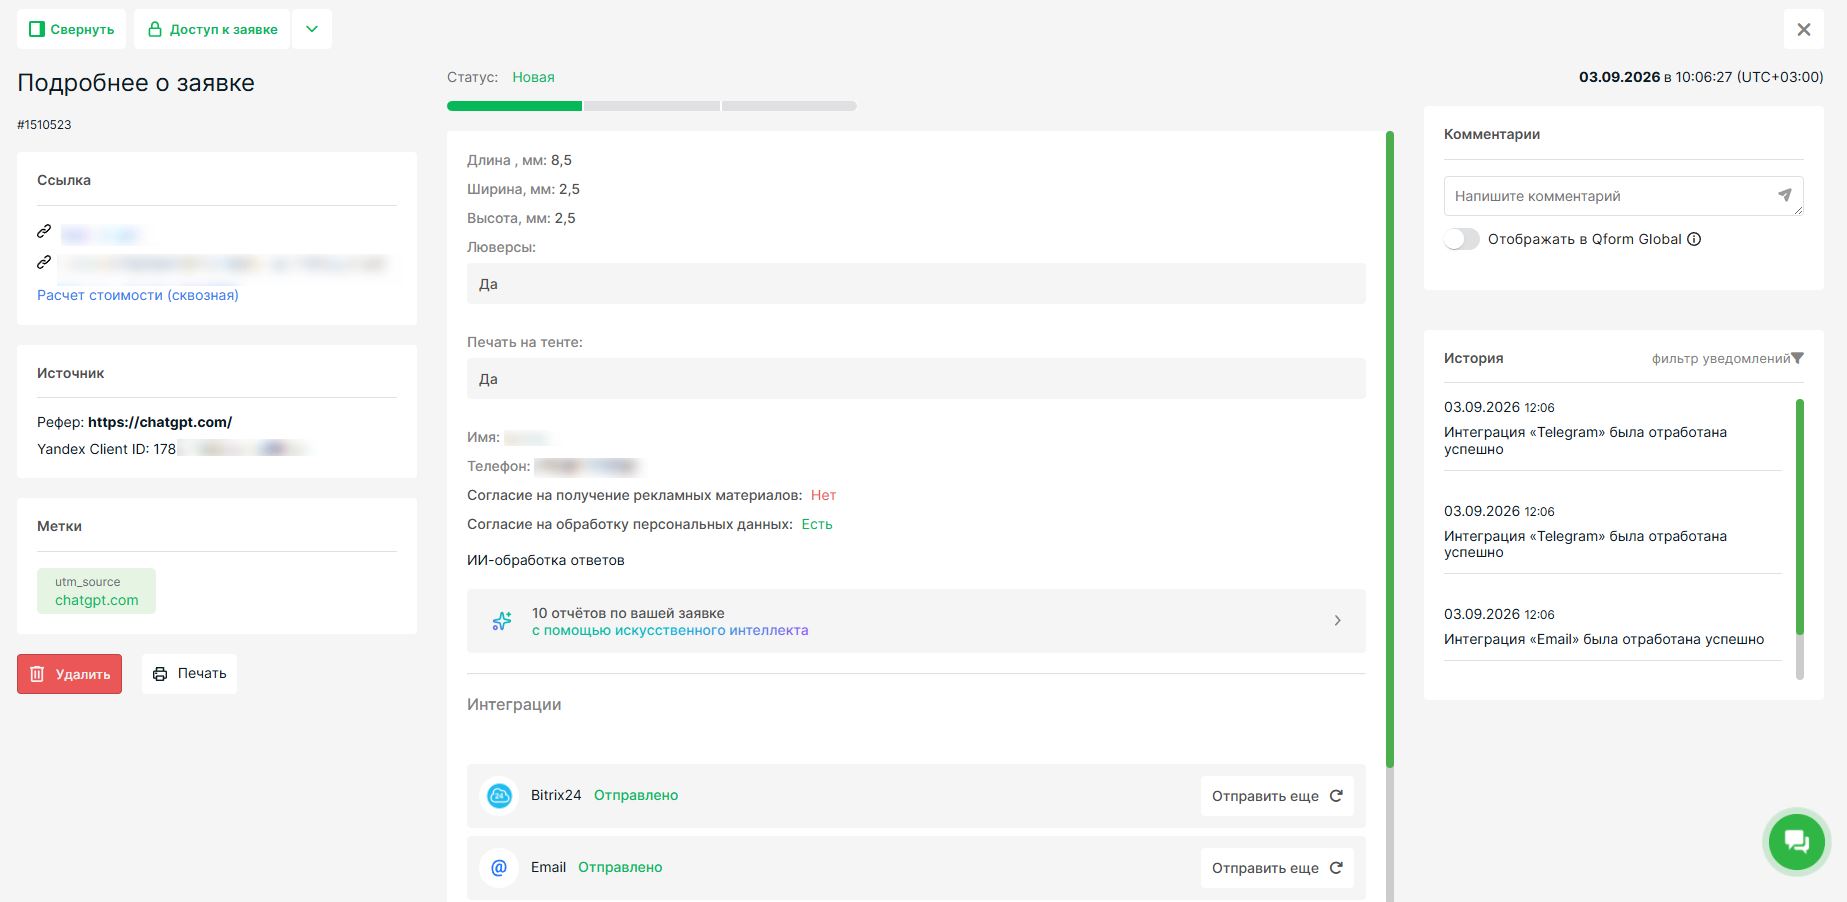
Так QForm закрывает именно этап сбора и первичной организации информации: респондент заполняет единую форму, ответы поступают в заданном формате, а исследователь получает подготовленный массив, с которым проще переходить к очистке, группировке и последующему анализу.
Типичные ошибки
- Анализ без очистки. Выбросы и дубли искажают средние и корреляции.
- Выводы по малой выборке. Тридцать ответов не покажут картину по всему рынку.
- Выбор метода «по привычке». Каждый критерий применим при определённых условиях: тип данных, распределение, размер групп.
- Погоня за значимостью. Если перебирать десятки гипотез, что-нибудь «значимое» найдётся случайно.
- Неудобная форма сбора. Поля без ограничений, разные шкалы, слишком длинная анкета приводят к ошибкам и отказам от заполнения.
- Игнорирование контекста. Цифры без понимания, как и от кого они получены, легко трактовать неверно.
Итог
Статистическая обработка данных начинается с вопросов и качественного сбора. Сначала вы определяете, какие первичные данные нужны, и собираете их в удобной структурированной форме, например через онлайн-форму или квиз в конструкторе. Затем выполняете первичную обработку, проводите первичный анализ, подбираете метод для статистической обработки результатов и всё это время опираетесь на основные принципы статистики. Если сделать каждый шаг аккуратно, цифры превращаются в рабочий инструмент для решений: от выбора продукта до выстраивания коммуникации с клиентами.