


ТОП-8 ИИ для создания аудиокниги в 2026 году

от 0,6 рубля за 1000 символов
Бесплатный доступ:
до 1000 символов в сутки без регистрации
- Каталог из более 3000 голосов на 83 языках с режиссерским режимом: эмоции, шепот и паузы задаются прямо в тексте.
- Поддерживает загрузку файлов в формате TXT, DOCX и PDF, а также клонирование голоса по короткой записи.
- Демоверсия помечена для личного использования, коммерческий проект требует платного тарифа.

оплата по факту — 13,2 рубля за 1000 знаков базово и 60 рублей за 1000 знаков на движке ElevenLabs
Бесплатный доступ:
нет
- Инструмент «Диктор» принимает текст до 5000 знаков за один запрос и выдает готовый MP3 за пару минут.
- Клонирование голоса стоит 279 рублей и требует образец от 15 секунд.
- Формат оплаты без подписки удобен для разовой озвучки одной главы или короткого рассказа.
от 390 рублей за 24 часа доступа
Бесплатный доступ:
нет
- Объединяет несколько топовых моделей синтеза речи в одном интерфейсе и умеет обрабатывать готовые записи — убирать шум и выравнивать громкость.
- Скорость, паузы и эмоциональность голоса настраиваются прямо на странице.
- По функционалу больше подходит для небольших книг.

от 890 рублей в месяц (Basic, 260 токенов), 1690 рублей (Pro, с видео) и 3990 рублей (Elite, безлимит на топовых моделях)
Бесплатный доступ:
бесплатно 15 токенов при регистрации без срока действия тарифы
- Агрегатор с доступом к ElevenLabs, Murf AI и русскоязычным голосовым моделям через Telegram-бот или веб-версию.
- Команда /elevenlabs открывает свыше 200 голосов и поддержку более 70 языков.
- Вариант интересен тем, кому кроме озвучки нужны и другие нейросети в одной подписке.

от 6 долларов (Starter) до 990 долларов (Business)
Бесплатный доступ:
тариф Free дает 10 000 кредитов в месяц — около 10 минут аудио без коммерческой лицензии
- Один из самых реалистичных синтезаторов речи на рынке.
- Живые паузы, дыхание и эмоциональные акценты в голосе.
- Поддерживает клонирование голоса и модель Dialogue для сцен с несколькими персонажами.
одна генерация обходится примерно в 60 токенов с общего счета платформы
Бесплатный доступ:
нет
- Подключает модель ElevenLabs с оплатой российской картой и русским интерфейсом.
- В тексте можно ставить теги эмоций — шепот, смех, вздох — и сразу получать выразительную озвучку.
- Формат подойдет блогерам и авторам аудиокниг, которым нужен голос ElevenLabs без прямой подписки на зарубежном сайте.

от 290 рублей в месяц
Бесплатный доступ:
нет
- Облачный сервис синтеза речи с оплатой по подписке, а не по числу символов.
- Ориентирован на регулярную работу с озвучкой.
- Перед подпиской стоит свериться с актуальным набором голосов на сайте.

Base 990 рублей (20 млн токенов), Ultra 1990 рублей (50 млн токенов), Pro 19990 рублей (700 млн токенов)
Бесплатный доступ:
5 генераций в сутки
- Агрегатор с доступом к ElevenLabs и еще более 50 нейросетям с единого баланса.
- Кроме озвучки текста доступна генерация изображений, видео и музыки в одном окне.
- При годовой оплате скидка на тариф Pro доходит до 52 процентов.
1. Apihost
Когда я впервые собирала аудиоверсию своей повести, меня подкупило то, что здесь не нужна подписка: вы просто пополняете кошелек и тратите его по мере начитки. Голоса разбиты на семейства — от базовых V1 и V5 за 0,6 ₽ за 1000 символов до Studio-версии с режиссерскими тегами за 15 ₽. Отдельно есть клонирование: модель собственного голоса Pro-clone обучается за 1000 ₽ и остается у вас навсегда, а озвучка ею идет по 6,5 ₽ за 1000 символов.
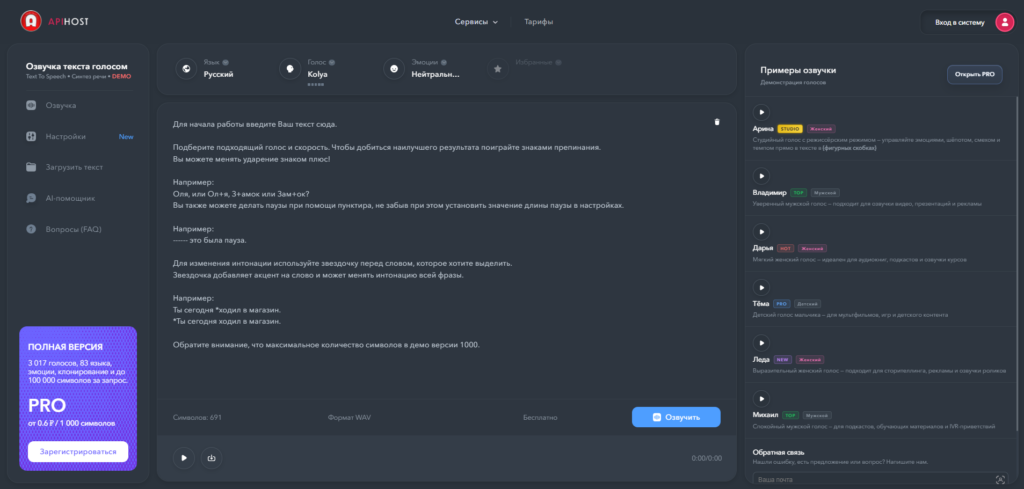
Что мне понравилось
- Длинные тексты до ~100 000 символов за один заход — главы не приходится дробить.
- Ровное звучание Pro-clone без скачков интонации, что важно для многочасовой книги.
- Рядом живут расшифровка аудио (2,4 ₽/мин), генератор текстов, картинки для обложки.
- Юрлицам выставляют счет и закрывающие документы.
Что стоит учесть
- Pro-clone и Studio-clone открываются только на тарифе Studio за 1800 ₽.
- Для яркой актерской начитки клон подходит хуже, чем для дикторской.
2. GPTunneL
Мне надоело держать открытыми пять вкладок с разными нейросетями. GPTunneL — российская платформа от команды ScriptHeads, где в одном кабинете лежат и текстовые модели, и звуковые: озвучка текста, расшифровка аудио и видео, музыкальная Grom Zvuk для фоновых подложек. Подписки здесь нет — деньги списываются за фактические генерации, а речь тарифицируется за 1 000 символов.
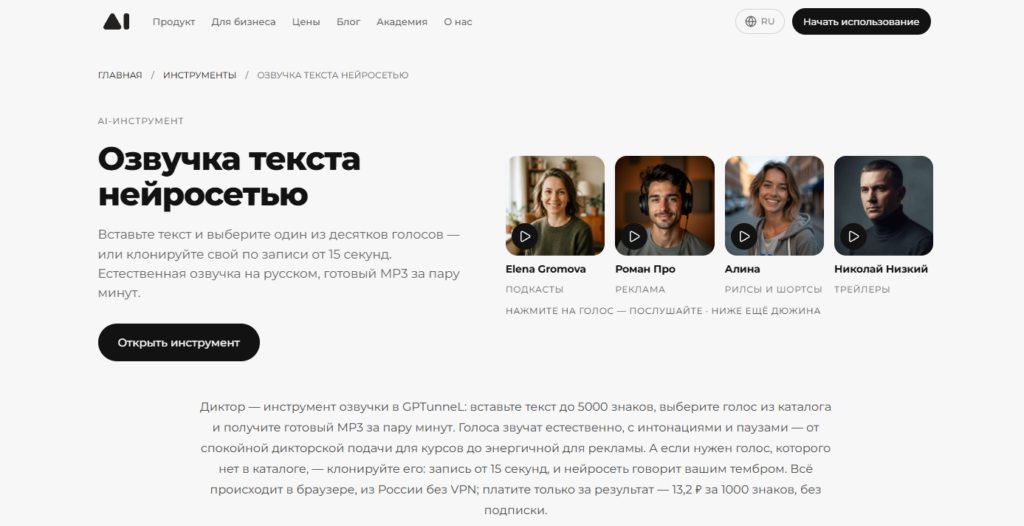
Что мне понравилось
- Минимальное пополнение — 50 ₽, порог входа почти незаметный.
- Оплата через СБП без комиссии, картами любых банков, а для юрлиц — счет и закрывающие документы.
- Скидка растет вместе с расходами: от 5% при 500 ₽ до 25% при 60 000 ₽ за месяц.
- Свои модели Grom и собственный инференс с резервными каналами.
- Академия с разборами: как озвучить текст, собрать песню по описанию, перевести аудио в текст.
Что стоит учесть
- Цены в личном кабинете отличаются от страницы тарифов.
- Бюджет длинной книги приходится считать калькулятором заранее.
- Каталог большой, и на выбор голоса и модели уходит время.
3. RANVIK
Генерация голоса, клонирование собственного тембра, музыка для фоновых подложек и текстовые модели живут в одном аккаунте с русским интерфейсом. Под капотом — ElevenLabs, Minimax, Suno и другие модели, так что для дикторской начитки, дубляжа или подкаста выбор тембров достаточный. Я загружала главы файлами и слушала готовые фрагменты почти сразу.
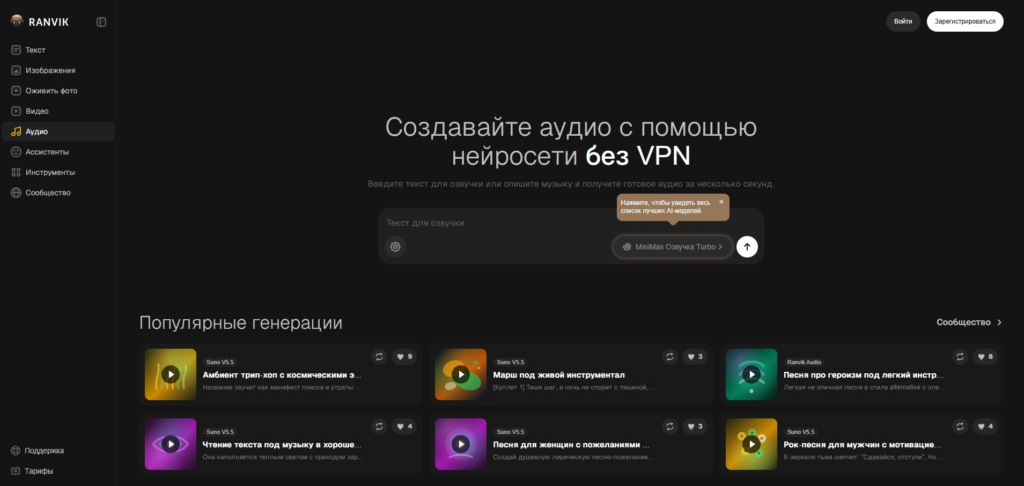
Что мне понравилось
- Озвучка, клонирование голоса и генерация музыки без переключения между сайтами.
- Приложения для RuStore, iPhone, Windows и MacOS — читаю и правлю текст с телефона.
- Тариф на сутки за 390 рублей — реально протестировать перед годовой подпиской за 8900.
- Поддержка и документация на русском.
Что стоит учесть
- Суточный лимит 500 000 токенов: роман целиком за один вечер не озвучить.
- Бесплатного тарифа нет, без аккаунта доступна лишь часть функций.
- Нет разметки глав и тонкой настройки интонаций по фразам.
4. Syntx AI
Признаюсь, я долго обходила стороной сервисы-агрегаторы, пока не попробовала собрать черновик аудиокниги в Syntx AI. Это чат-бот в Телеграме с веб-версией, где в одном окне собраны GPT-5, Claude, Gemini, Grok и DeepSeek. Для озвучки он пригодится на подготовительном этапе: вычитать главу, расставить смысловые акценты, сократить длинноты — а затем прослушать результат через синтез речи. Интерфейс русский, оплата картами российских банков.
Что мне понравилось
- Несколько языковых моделей по одной подписке, переключение прямо в диалоге.
- Озвучивание текста и расшифровка голосовых сообщений.
- Работа через Телеграм, браузер и мобильные приложения.
- Бесплатный стартовый пакет запросов для знакомства.
Что стоит учесть
- Тонкой настройки пауз, ударений и эмоций, как в профильных студиях, здесь нет.
- Объемную рукопись придется дробить на фрагменты.
- Выбор голосов скромнее, чем у специализированных синтезаторов.
- Бесплатный доступ ограничен суточным лимитом.
5. ElevenLabs
Когда я впервые загрузила сюда главу своей повести, то минут пять переслушивала запись: голос дышал, выдерживал паузы и усмехался ровно там, где задумывалась ирония. Сервис синтезирует речь более чем на 70 языках, и русский звучит без акцента и с верными ударениями. В библиотеке собраны мужские и женские голоса разного возраста и тембра — каждый можно послушать до генерации. Интонацию вы задаете прямо в тексте тегами: шепот, смех, вздох, крик.
Что мне понравилось
- Живое звучание с придыханием и естественным ритмом фразы.
- Разные голоса под рассказчика и персонажей одной книги.
- Ползунки скорости речи, выразительности и четкости произношения.
- Готовый файл в MP3 или WAV за считаные секунды.
Что стоит учесть
- В именах собственных и редких словах иногда встречаются ошибки в ударениях.
- Объемный текст приходится дробить на фрагменты.
- Бесплатного лимита символов хватает примерно на пару минут звучания.
6. Study AI
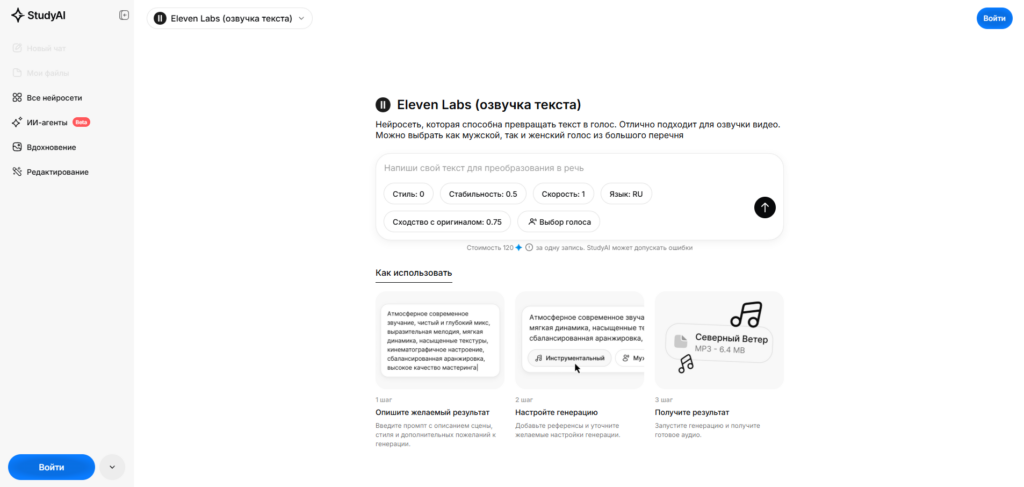
Эту площадку я держу в закладках как «швейцарский нож» книжного проекта: под одной подпиской собрано больше 90 нейросетей. Отдельной кнопки «озвучить главу» тут нет, зато есть почти все, что окружает аудиокнигу. В чате я сокращаю текст до дикторского сценария, через Suno подбираю фоновую музыку, а генератором изображений рисую обложку для плеера. Интерфейс русскоязычный, оплата проходит картой, по СБП, через SberPay или T-Pay.
Что понравилось
- ChatGPT 5.2, Claude Sonnet 4.5, Gemini 3 PRO, Midjourney, Suno и другие модели в одном окне.
- Собственные инструменты: генераторы видео, презентаций, афиш, логотипов, оживление фото.
- DeepSeek 3.2 и Qwen 3 работают без подписки.
- Библиотека готовых промтов и пользовательские оценки у каждой модели.
Что стоит учесть
- Токены списываются с учетом истории диалога, длинные тексты выходят дороже.
- Бесплатные модели отвечают медленнее: запросы идут общей очередью.
- Поддержка на связи с 10:00 до 19:00.
- Месячная подписка продлевается автоматически.
7. chad
Мне хотелось найти площадку, где голосовой синтез соседствует с текстовыми моделями — и chad оказался как раз таким вариантом. Здесь есть отдельная функция озвучки текста и синтез речи на базе TBank TTS, а рядом — Suno v5 и Udio для фоновой музыки к аудиокниге. Отредактировать главу, сократить длинноты, а потом сразу превратить ее в звук можно в одном окне, без переключения между вкладками.
Что понравилось
- Оплата российскими картами, сервис внесен в реестр Минцифры
- Тарифы от 290 ₽ за 120 000 искр до 1 690 ₽ за 900 000
- Работает в браузере, Telegram и приложениях из RuStore, App Store, Google Play
- Больше 50 моделей: GPT, Claude, Gemini, DeepSeek, Grok
- Оценка 4,6 по 4000+ отзывам пользователей
Что стоит учесть
- Искры на личных тарифах сгорают в конце месяца
- Расход по моделям различается — от 0,3 до 15 искр за слово
- Выбор голосов и настроек интонации скромнее, чем в узкопрофильных студиях озвучки
8. MashaGPT
Когда я искала способ озвучить свою повесть и не собирать при этом десяток отдельных подписок, остановилась на MashaGPT. Это российская площадка, где в одном окне собрано больше 50 нейросетей, в том числе ElevenLabs с эмоциональной начиткой и Whisper v3 для распознавания речи. Главу я правлю в Canvas прямо в чате, а затем отправляю на озвучку. Оплата идет российской картой, регистрироваться в зарубежных сервисах не требуется.
Что мне понравилось
- ElevenLabs TTS V3 с передачей интонаций и Sound Effects V2 для фоновых звуков.
- Разбор рукописи в форматах PDF и DOC прямо в диалоге.
- Бесплатный тариф на 5 генераций в сутки, без привязки карты.
- Программы для Windows, macOS, iPhone и Android плюс расширение для браузера.
- Подписка от 990 ₽ в месяц, при оплате за год скидка до 52%.
Что стоит учесть
- Озвучка доступна с тарифов Ultra и Pro, на Base ее нет.
- Расход считается в токенах — к этой арифметике привыкаешь не сразу.
- Тариф Pro за 19 990 ₽ рассчитан скорее на команду, чем на одного автора.
От рукописи до аудиофайла: пошаговый маршрут озвучки нейросетью
Если разложить весь процесс по полочкам, окажется, что превратить книгу в аудиоформат через нейросеть не сложнее, чем оформить обычный документ на печать. Разница только в том, что вместо принтера на выходе получаете голос, а вместо настроек бумаги — параметры тембра, скорости и пауз. Но чтобы результат звучал живо, а не как робот, зачитывающий инструкцию к стиральной машине, важно пройти путь в правильном порядке, а не хватать первый попавшийся сервис и бросать в него весь текст целиком.
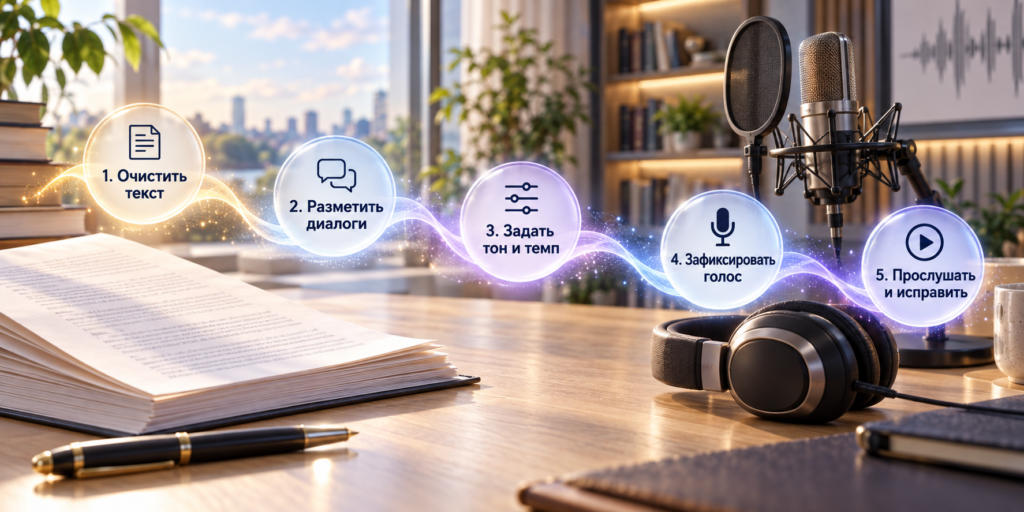
Шаг 1. Подготовка исходного текста
Прежде чем загружать книгу в нейросеть, текст нужно почистить от всего, что не предназначено для голоса. Сноски, номера страниц, повторяющиеся колонтитулы, странные символы после сканирования — все это машина честно попытается прочитать вслух, и результат получится комичным. Отдельно стоит проверить кавычки, тире и переносы слов: если рукопись собрана из разных источников, форматирование часто скачет, а нейросеть реагирует на такие сбои непредсказуемыми паузами. Пять минут на вычитку текста перед загрузкой экономят потом полчаса переслушивания готового аудио.
Шаг 2. Разбор диалогов
Диалоги — самое слабое место почти любой автоматической озвучки, потому что нейросеть по умолчанию не различает, кто именно говорит. Если в книге пять персонажей и все реплики идут подряд без явной разметки, голос останется одним и тем же на протяжении всей сцены, и читатель быстро потеряет нить разговора. Помогает простая разметка прямо в тексте: перед репликой каждого героя можно указать имя или короткую пометку тона — «шепотом», «раздраженно», «с улыбкой» — и нейросеть учтет эту подсказку при генерации. Чем четче разделены реплики, тем естественнее звучит финальная запись, особенно в динамичных диалоговых сценах.
Шаг 3. Работа с промптом
Промпт — это не просто команда «озвучь текст», а полноценная инструкция для голосовой модели, и от ее формулировки зависит половина результата. Стоит указать общий тон повествования — спокойный рассказ, напряженный триллер, легкая ирония — а также темп речи и то, нужны ли смысловые паузы между предложениями. Хорошая практика: описывать не только что читать, но и как — например, «читай как аудиогид по музею, размеренно и с теплой интонацией» работает лучше сухого технического запроса. Если первая попытка вышла плоской, промпт можно и нужно переписывать: большинство современных нейросетей позволяют перегенерировать фрагмент за секунды.
Шаг 4. Выбор и фиксация голоса
Один из самых частых промахов новичков — использование разных голосов в разных главах книги, просто потому что забыли зафиксировать настройку. Прежде чем начинать масштабную озвучку, стоит протестировать несколько голосов на одном и том же отрывке и выбрать тот, который подходит по тембру и характеру произведения. После выбора важно сохранить именно эти параметры — идентификатор голоса, скорость, тон — и применять их ко всем последующим главам без изменений. Иначе слушатель заметит, что диктор словно менялся на середине книги, а это разрушает ощущение целостной аудиокниги.
Шаг 5. Проверка результата
Готовый фрагмент никогда не стоит публиковать без предварительного прослушивания, даже если нейросеть выглядит надежной. Нужно обратить внимание на ударения в именах собственных и редких словах — здесь машина ошибается чаще всего — а также на естественность пауз между предложениями и абзацами. Если что-то звучит неправильно, большинство сервисов позволяют точечно исправить проблемное слово через фонетическую транскрипцию или альтернативное написание, не перезапуская всю главу. Такая финальная вычитка на слух занимает немного времени, но именно она отделяет аккуратную аудиокнигу от сырой автоматической озвучки.
Чистим текст: что убрать из рукописи перед загрузкой в нейросеть
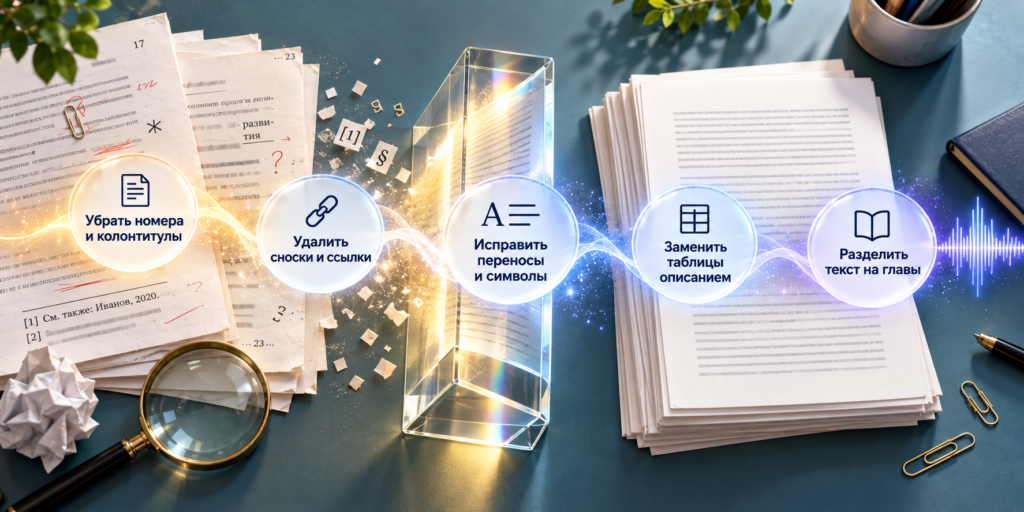
Рукопись, которая выглядит аккуратно на экране, часто превращается в хаос, когда ее читает вслух машина. Нейросеть не понимает контекст оформления — она видит символ и пытается его произнести, даже если для человеческого глаза этот символ был просто разделителем страниц. Поэтому перед загрузкой текста стоит потратить время на вычитку, и это далеко не формальность, а прямое условие качественной озвучки.
Что реально портит звучание
Первое, от чего нужно избавиться, — это технический мусор, который остается после сканирования или экспорта из PDF. Номера страниц, повторяющиеся колонтитулы с названием книги, автоматические сноски и ссылки на источники — все это нейросеть прочитает буквально, вставляя посреди главы обрывочные цифры и фразы вроде «см. примечание 14». Отдельная беда — символы разрыва строки и переносы слов, которые остались после верстки: если слово разбито дефисом на две строки, а перенос не убран, машина может произнести его как два отдельных куска.
Второй источник проблем — визуальные элементы, которые не переводятся в звук напрямую. Таблицы, схемы, подписи к иллюстрациям и списки литературы лучше удалить целиком или заменить коротким текстовым описанием, если это важно для смысла главы. То же касается специальных символов: тире разных видов, кавычки-лапки вперемешку с кавычками-елочками, лишние пробелы и невидимые символы из старых текстовых редакторов — все это стоит унифицировать одним проходом через функцию поиска и замены.
Как быстро проверить рукопись перед загрузкой
Не обязательно вычитывать книгу построчно вручную — большинство проблем ловится через простую автоматическую проверку. Стоит прогнать текст через поиск по ключевым паттернам: цифры без единиц измерения, повторяющиеся заголовки, странные последовательности символов вроде решеток или квадратных скобок из OCR-распознавания. Полезно также разбить текст на главы отдельными файлами, а не грузить книгу целиком одним куском — так проще заметить ошибку в конкретном месте и не пересобирать заново весь массив аудио.
Отдельно стоит проверить прямую речь и диалоги — на этом этапе достаточно убедиться, что реплики отделены друг от друга явно, без слипания в один абзац. Подробно про разметку диалогов и расстановку тона для персонажей поговорим в следующем разделе, потому что это отдельная и не менее важная часть подготовки текста перед озвучкой.
Язык, который понимает машина: секреты грамотного промпта
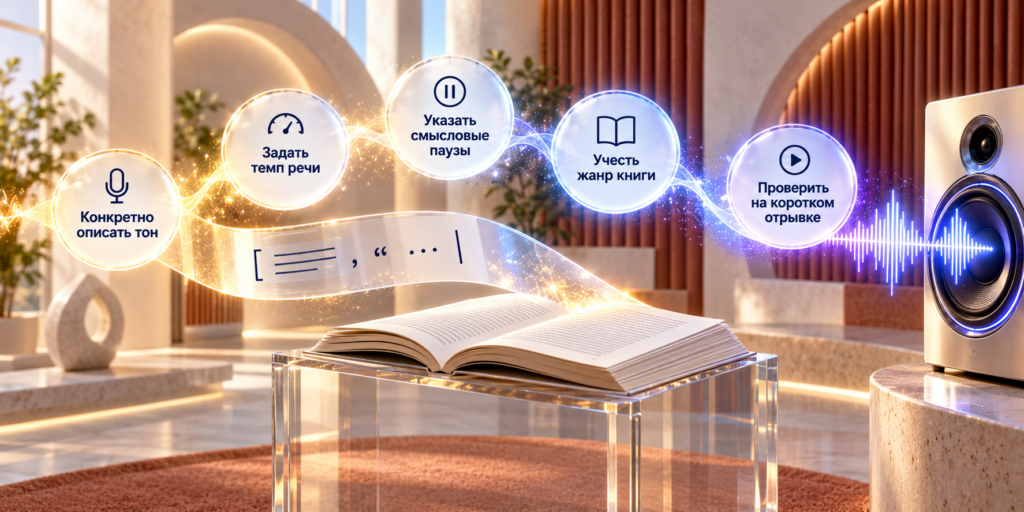
Промпт для озвучки книги — это не магическое заклинание, а обычная инструкция, только сформулированная на понятном нейросети языке. Многие новички пишут что-то вроде «озвучь текст спокойным голосом» и потом удивляются, почему результат звучит плоско. Секрет в том, что модель воспринимает буквально каждое слово запроса, и чем конкретнее описана задача, тем точнее совпадет результат с тем, что вы себе представляли.
Из чего складывается хороший промпт
Рабочий промпт держится на нескольких элементах, и пропуск любого из них сразу сказывается на звучании. Во-первых, нужен общий тон повествования — спокойный рассказчик, напряженный триллер, теплая история для детей или сухой деловой текст. Во-вторых, важен темп: быстрая читка подходит для динамичных сцен, а медленная — для описаний природы или философских размышлений героя. В-третьих, стоит указать паузы — где делать смысловые остановки, а где, наоборот, читать текст слитно, без разрывов на каждой запятой.
Полезно добавлять сравнения из реальной жизни, потому что нейросети хорошо реагируют на образные описания. Фраза «читай как диктор новостей, четко и без лишних эмоций» работает точнее, чем абстрактное «читай нейтрально». То же с художественной прозой: «озвучь как рассказчик у костра, немного таинственно, с растяжкой на длинных словах» дает модели конкретный образ для подражания, а не размытое пожелание.
Частые ошибки при составлении промпта
Одна из типичных ошибок — слишком общий запрос без деталей, из-за которого нейросеть выбирает усредненный вариант интонации, никак не связанный с содержанием главы. Другая крайность — перегруженный промпт с десятком противоречивых требований одновременно: «читай быстро, но с длинными паузами, эмоционально, но сдержанно» — модель просто не сможет удовлетворить все условия и выдаст компромиссный, невыразительный результат. Третья частая проблема — игнорирование жанра книги: инструкция, которая отлично работает для делового нон-фикшена, звучит нелепо на фэнтези-романе с яркими персонажами.
Как проверить промпт перед озвучкой всей книги
Прежде чем запускать генерацию на весь текст, стоит протестировать промпт на коротком отрывке из одной-двух страниц. Это позволяет услышать, насколько точно нейросеть поняла заданный тон, и скорректировать формулировку без потери времени на повторную обработку сотен страниц. Если результат близок к нужному, но не идеален, часто достаточно поменять одно-два слова в описании — например, заменить «эмоционально» на «с легкой тревогой в голосе» — чтобы добиться более точного попадания в задуманную интонацию.
Библиотека готовых команд: промпты, которые сразу работают
Иногда проще взять рабочий шаблон и подогнать его под свою книгу, чем изобретать формулировку с нуля. Собрала здесь набор промптов, которые проверила на разных жанрах текста — от делового нон-фикшена до атмосферного фэнтези. Берите за основу и меняйте детали под конкретную главу.
Для художественной прозы
«Читай как опытный рассказчик, размеренно, с теплой интонацией. Делай короткую паузу после каждого абзаца и слегка замедляйся на описаниях природы или внутренних размышлениях героя».
«Озвучь как в атмосферном аудиоспектакле: голос слегка приглушенный, с ощущением тайны, темп чуть медленнее обычного разговора. На кульминационных фразах добавь легкое напряжение в тоне».
Для диалогов и динамичных сцен
«Читай реплики персонажей живо и быстро, как настоящий разговор между людьми, а не по бумажке. На восклицательных фразах добавляй эмоциональный акцент, на вопросах — легкое повышение тона к концу фразы».
«Озвучь спор между героями энергично, с короткими паузами между репликами, будто оба персонажа перебивают друг друга и не могут договориться».
Для деловой и обучающей литературы
«Читай как ведущий делового подкаста: четко, уверенно, без лишних эмоций, в среднем темпе. Делай смысловую паузу перед каждым новым тезисом или списком».
«Озвучь текст как структурированную лекцию: спокойный, размеренный голос, с легким акцентом на ключевых терминах и цифрах, чтобы слушатель точно их не пропустил».
Для детской литературы
«Читай мягко и дружелюбно, с легкой игривой интонацией, как будто рассказываешь сказку перед сном. На забавных моментах слегка повышай тон, чтобы передать удивление или радость персонажа».
Универсальный промпт для тестового отрывка
«Прочитай этот фрагмент в естественном разговорном темпе, без монотонности, с четкими паузами между предложениями. Обозначь интонационно смысловые акценты там, где это логично по содержанию текста».
Такой универсальный вариант удобно использовать первым — на коротком отрывке в начале работы, чтобы понять, как конкретная нейросеть интерпретирует базовые указания, а дальше уже дорабатывать промпт под особенности вашей книги.
Чья это озвучка: вопросы авторского права и выхода книги в свет
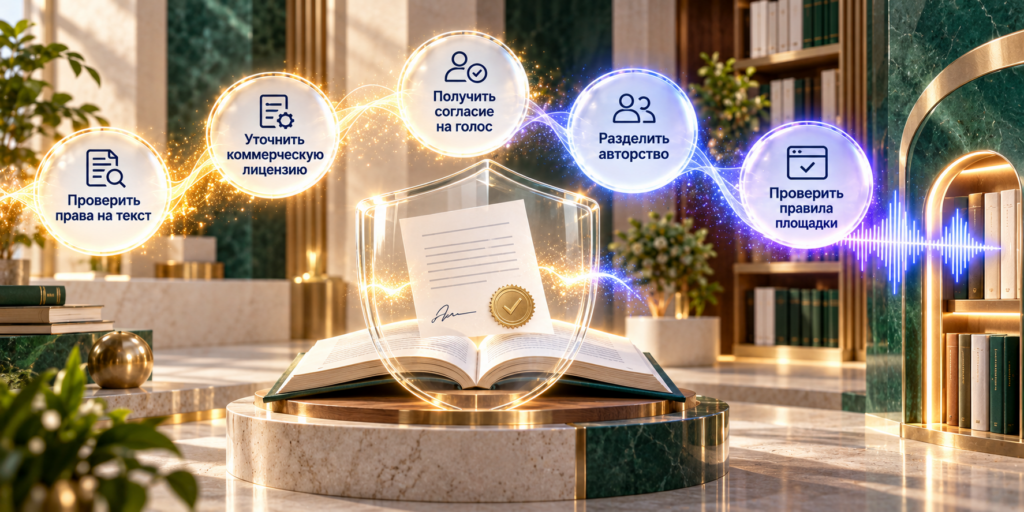
Прежде чем публиковать готовую аудиокнигу, стоит разобраться в одной важной детали: озвучка нейросетью не отменяет обычных правил авторского права, а добавляет к ним еще один слой вопросов. Здесь пересекаются сразу три темы — права на исходный текст, права на сгенерированный голос и правила конкретных площадок, где вы планируете публикацию.
Права на сам текст книги
Если вы озвучиваете чужое произведение, право на распространение аудиоверсии остается за автором или издательством, а не переходит к вам автоматически просто потому, что вы прогнали текст через нейросеть. Официально озвучить книгу без разрешения правообладателя можно только в одном случае — если произведение перешло в общественное достояние, а это происходит через 70 лет после смерти автора. Во всех остальных случаях распространение готовой аудиокниги без договора с правообладателем формально считается нарушением, даже если сама озвучка сделана бесплатным сервисом.
Права на голос, сгенерированный нейросетью
Здесь все зависит от конкретного сервиса и тарифа. У ElevenLabs, например, четкое разделение: на бесплатном плане контент можно использовать только для личных целей, а в названии файла нужно указывать «elevenlabs.io» или «11.ai». Коммерческое использование — продажа готовой аудиокниги, публикация на платформах вроде Audible — открывается только с платного тарифа, начиная от Starter. При этом права на аудио, созданное во время действия платной подписки, сохраняются бессрочно, даже если позже вы перейдете на бесплатный план или откажетесь от подписки вовсе.
Если вы клонируете чужой голос через нейросеть, дополнительно требуется согласие владельца этого голоса — большинство сервисов прямо прописывают это условие в пользовательском соглашении. С российским законодательством ситуация проще: Гражданский кодекс не признает нейросеть автором, поэтому права на итоговый результат принадлежат человеку, который задал условия создания — то есть вам, если это подтверждено соглашением с сервисом.
Слои прав на готовую аудиокнигу
У полноценной аудиокниги может быть до трех правообладателей одновременно: автор оригинального текста, чтец или актер озвучивания, и отдельно — владелец прав на перевод, если книга переводная. Когда роль чтеца выполняет нейросеть, вопрос смещается: правообладателем голоса выступает не модель, а тот, кто оплатил коммерческую лицензию сервиса и настроил генерацию. Это стоит четко фиксировать при публикации — указывать авторство текста отдельно от факта использования ИИ-озвучки, чтобы не возникло путаницы с площадками распространения.
Что проверить перед публикацией
Перед выходом аудиокниги в свет полезно свериться с тремя пунктами: подтверждено ли право на озвучку исходного текста, соответствует ли тариф использованного сервиса синтеза речи коммерческим целям публикации, и требует ли площадка размещения (магазин аудиокниг, подкаст-платформа, собственный сайт) отдельного указания на использование искусственного интеллекта в описании. Многие современные площадки уже добавляют такую маркировку как стандартное требование, и ее отсутствие может привести к снятию контента после модерации.
Когда нейросеть капризничает: разбор частых сбоев и их устранение
Даже у надежных сервисов озвучки случаются моменты, когда результат выходит странным: голос звучит роботом, посреди фразы появляется щелчок, или система вовсе отказывается генерировать длинный отрывок. Разберем самые частые проблемы и рабочие способы их обойти.
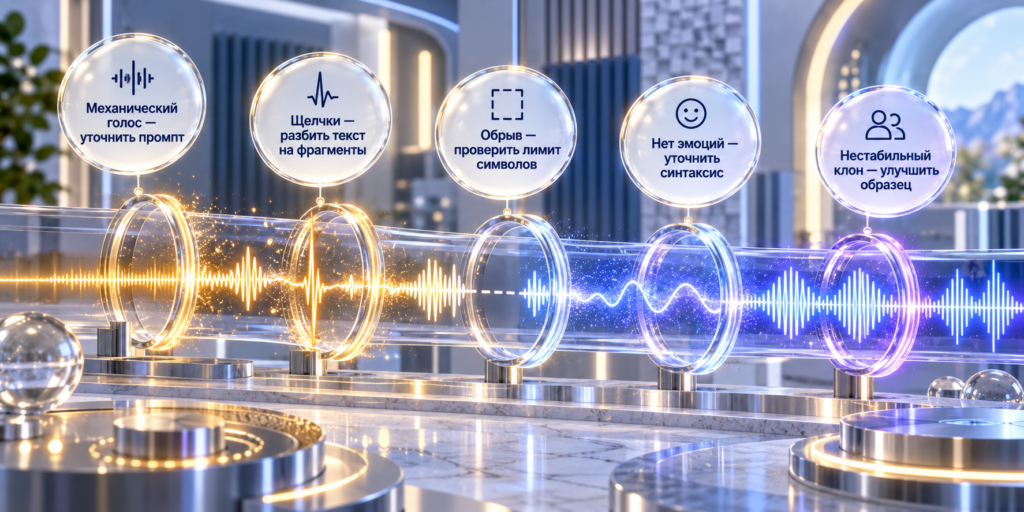
Голос звучит механически, без живых интонаций
Такое чаще всего происходит, когда промпт слишком общий или отсутствует вовсе — модель по умолчанию читает текст в нейтральном режиме без выраженной эмоции. Решение простое: вернуться к формулировке задачи и добавить конкретный образ подачи, как разбирали в разделе про промпты. Иногда причина в самом выбранном голосе — некоторые голосовые модели изначально звучат суше остальных, и здесь помогает просто протестировать альтернативный вариант из библиотеки сервиса на том же отрывке.
В середине аудио появляются щелчки, шипение или обрывы
Артефакты звука обычно связаны с длиной текста за один запрос. Многие сервисы обрабатывают большие объемы кусками, и на стыке между кусками может проскочить короткий щелчок или неестественная пауза. Помогает разбивка текста на более короткие фрагменты — по абзацу или по сцене, а не по главе целиком — и последующая склейка готовых файлов в аудиоредакторе. Если щелчки появляются даже на коротких отрывках, стоит проверить исходный текст на скрытые символы — невидимые пробелы или остатки форматирования часто вызывают именно такие сбои.
Сервис обрывает генерацию на середине текста
Ограничение по объему символов за один запрос — обычная практика у большинства нейросетей, и превышение лимита либо обрывает аудио, либо выдает ошибку. Прежде чем загружать целую главу, стоит уточнить максимальный объем символов на одну генерацию у конкретного сервиса и заранее разбить рукопись на части нужного размера. Полезно также сохранять текст в отдельных файлах по главам — тогда при сбое придется перезапустить только один фрагмент, а не всю книгу.
Нейросеть неправильно интерпретирует эмоциональные пометки
Если в тексте стоят подсказки тона вроде «раздраженно» или «шепотом», а голос звучит одинаково независимо от пометки, вероятная причина — сервис просто не поддерживает такую разметку в текущей версии модели. Стоит свериться с документацией конкретного инструмента: некоторые нейросети требуют специальный синтаксис для эмоциональных тегов, а не произвольный текст в скобках. Если поддержки нет вовсе, единственный обходной вариант — управлять эмоцией через сам промпт для всего фрагмента, а не точечными пометками внутри текста.
Клонированный голос звучит нестабильно от файла к файлу
Разброс качества при клонировании голоса часто связан с исходным образцом записи. Если запись для клонирования была короткой, с шумом на фоне или неровной по громкости, модель воспроизводит эти же дефекты в каждой новой генерации. Лучше заранее подготовить чистый образец голоса длиной хотя бы в минуту, записанный в тихом помещении без посторонних звуков, и заново обучить голос на этой записи — качество итогового результата вырастет заметно.
FAQ: отвечаем на вопросы про озвучку книг нейросетью
Собрала здесь вопросы, которые чаще всего возникают у тех, кто впервые пробует озвучить книгу нейросетью. Ответы короткие и по делу — без общих рассуждений, только конкретика по каждому пункту.
Можно ли озвучить книгу нейросетью без опыта в звукозаписи?
Да, современные сервисы синтеза речи рассчитаны именно на пользователей без технического背ground. Достаточно загрузить текст, выбрать голос и настроить промпт — специальные знания монтажа звука не нужны.
Как озвучить книгу с помощью ИИ, если раньше вы не работали с такими сервисами?
Начните с короткого тестового отрывка на одном из бесплатных тарифов, чтобы понять логику интерфейса и оценить качество голоса. После этого переходите к полноценной работе с текстом по схеме: чистка рукописи, разметка диалогов, подбор промпта и фиксация выбранного голоса на всю книгу.
Реально ли озвучить книгу нейросетью бесплатно целиком, а не только пару абзацев?
Полностью бесплатная озвучка книги нейросетью на практике встречается редко — большинство сервисов дают демодоступ с ограничением по символам в день или в месяц. Для короткого рассказа бесплатного лимита может хватить, а для объемного романа обычно требуется платный тариф или несколько бесплатных аккаунтов по очереди.
Какая нейросеть для создания аудиокниги подойдет новичку лучше других?
Ориентируйтесь на сервисы с понятным русским интерфейсом и возможностью протестировать голос перед оплатой — в этом обзоре разбирали конкретные варианты с ценами и лимитами. Для художественной прозы важнее реалистичность интонации, а для деловой литературы — четкость и стабильность голоса.
Может ли ИИ озвучить книгу так, чтобы это звучало живо, а не механически?
Может, но результат сильно зависит от качества промпта и выбранного голоса, а не только от самого сервиса. При грамотной настройке современные модели передают эмоции, паузы и даже легкие интонационные акценты почти на уровне живого диктора.
Чем озвучка книги с помощью нейросети отличается от обычной озвучки видеоролика?
Нейросеть для озвучки книг работает с гораздо большим объемом текста и требует стабильности голоса на протяжении многих часов звучания, а не пары минут. Кроме того, книга чаще содержит диалоги и смену интонации между персонажами, что усложняет задачу по сравнению с коротким рекламным роликом.
Существует ли отдельный ИИ для аудиокниг, который справляется с несколькими голосами персонажей?
Да, некоторые платформы поддерживают мультиголосовую озвучку и позволяют закрепить отдельный тембр за каждым героем книги. Если такой функции нет, разные голоса можно совместить вручную, склеив отдельно озвученные реплики в аудиоредакторе.
Стоит ли искать именно нейросеть для озвучки аудиокниг или подойдет любой сервис синтеза речи?
Обычная нейросеть для аудиокниг общего назначения справится с озвучкой текста, но специализированные инструменты часто удобнее — там есть готовые настройки для длинных текстов и сохранения одного голоса на весь проект. Для разовой короткой задачи разница не критична, а для целой книги специализированный сервис сэкономит время на ручной настройке.
Как убедиться, что ИИ-озвучка книги бесплатно не ограничивается парой минут звука?
Перед началом работы проверьте условия конкретного тарифа: у большинства сервисов бесплатный лимит указан в символах или минутах на месяц, а не в количестве файлов. Если планируете озвучить книгу с помощью ИИ бесплатно целиком, разумно заранее посчитать объем текста в символах и сравнить с лимитом сервиса.
Как искусственный интеллект и современная технология синтеза речи вообще изменили процесс работы над аудиокнигой?
Раньше озвучка требовала студии, диктора и нескольких дней монтажа, а теперь весь процесс с помощью искусственного интеллекта укладывается в несколько часов за компьютером. Технология не заменяет творческую часть работы — выбор тона, темпа и характера голоса все равно остается за человеком, но техническая нагрузка снизилась в разы.
Озвучка книг через ИИ давно перестала быть развлечением и превратилась в рабочий инструмент с понятной схемой действий. Итоговое качество зависит не столько от выбора сервиса, сколько от подготовки: чистого текста, размеченных диалогов, точного промпта и одного зафиксированного голоса на всю книгу. Техническую часть нейросеть берет на себя, а тон и характер повествования все равно остаются творческим решением автора проекта.
А у вас уже был опыт озвучки текста нейросетью? Поделитесь в комментариях, какой сервис пробовали и что из этого вышло.



Не люблю аудиокниги, потому что читают не так, ак я представляю текст у себя в голове😅озвучка электронных книг ИИ-голосом спасением стало, когда хочется послушать что-то в дороге, все настраиваю под себя и готово! Мне помог Apihost, я обычно заранее озвучивала побольше текста, чтобы запись не обрывалась на самом интересном месте