



ТОП-11 ИИ для добавления звука в видео онлайн в 2026 году

тарифы от 199 рублей за 7 дней (LITE, 400 токенов)
Бесплатный доступ:
часть моделей работает бесплатно в общей очереди

Base 990 рублей в месяц, Ultra 1990 рублей в месяц, Pro 19990 рублей в месяц
Бесплатный доступ:
бесплатно 5 генераций в сутки
Google AI Plus — от $4,99/мес.; Pro — $19,99/мес.; Ultra — от $99,99/мес.
Бесплатный доступ:
есть, с ограничениями
Standard — от $8,80/мес.; Pro — от $32,56/мес.; Premier — от $80,96/мес.
Бесплатный доступ:
есть, с ограничениями

пробный — 299 ₽/7 дней; Pro — 990 ₽/мес.; Premium — 1 990 ₽/мес.; Elite — 4 990 ₽/мес.
Бесплатный доступ:
нет

80 за секунду видео
Бесплатный доступ:
есть, ограниченный тариф Free
Plus — $8/мес.; Premium — $30/мес.; Super — $100/мес.; Ultra — $200/мес.
Бесплатный доступ:
есть, с ограничениями
Creator — $19/мес.; Professional — $75/мес.
Бесплатный доступ:
есть, для отдельных VFX-функций
Basic — $15/мес.; Standard — $36/мес.; Advanced — от $79/мес.
Бесплатный доступ:
есть, ежедневные кредиты
Тестовые сутки 390 рублей, неделя 590 рублей, месяц 1390 рублей, год 8900 рублей; суточный лимит 500 000 токенов
Бесплатный доступ:
бесплатная пробная генерация в базовом режиме

от 50 ₽ — минимальное пополнение баланса
Бесплатный доступ:
нет
1. Study AI
В каталоге платформы рядом стоят Hailuo и MiniMax H3, и именно вокруг них строится работа со звуком. Здесь аудио рождается вместе с картинкой, а не приклеивается к готовому ролику отдельным шагом. У модели два раздельных кодировщика, один отвечает за изображение, второй за дорожку, поэтому реплики и фоновый шум совпадают с движением губ и действием в кадре. В промпте вы прямо прописываете, что говорит персонаж, какая музыка звучит и какой шум остается позади.
Что понравилось
- Аудиодорожка синхронизирована с видео на этапе генерации, отдельный монтаж дорожки отпадает.
- 11 языков диалогов и озвучки, включая русский: реплики и субтитры задаются прямо в промпте.
- Режим Ref2VA принимает до 12 референсов: 9 изображений, 3 видео и 3 аудиофайла.
- Отдельный модуль апскейла до 2K для роликов, где важна фактура и мелкие надписи.
Что стоит учесть
- Один ролик длится максимум 15 секунд.
- Базовая генерация идет в 768p, повышение разрешения запускается второй операцией.
2. MashaGPT
Сводить картинку и звук в одном окне заметно спокойнее, чем прыгать между пятью вкладками. Здесь под одной подпиской собраны видеомодели Kling 3.0, Veo 3.1, Sora 2, Runway Gen-4.5, Hailuo и Seedance, а рядом живут синтез музыки Suno, распознавание речи Whisper и озвучка ElevenLabs. Готовый ролик обычно появляется за 1-3 минуты, и вы успеваете перебрать пару версий, пока остывает чай. Мой совет: начните с бесплатного тарифа, там пять генераций в сутки суммарно на чат, изображения и музыку. Так вы поймете, какая модель лучше держит ваш тип сцен, и уже потом возьмете платный план.

Что понравилось
- Больше 50 моделей в одном интерфейсе, от видеогенерации до музыки и голоса.
- Бесплатный старт: 5 генераций в сутки, регистрация без привязки карты.
- Ролик собирается за 1-3 минуты, промпт, стиль и длительность можно менять и запускать заново.
- Распознавание речи Whisper и озвучка ElevenLabs закрывают работу с голосом в том же окне.
Что стоит учесть
Видеомодели расходуют энергию быстрее текстовых, так что запас стоит планировать заранее.
Перейти на сайт сервиса >>>3. Google Veo
Задача с наложением дорожки на готовую картинку тут решается иначе: звук рождается вместе с роликом, а не подклеивается поверх. Модель принимает текстовое описание или фотографию и собирает короткую сцену с движением камеры, светом и синхронной дорожкой. Список приемов знаком каждому, кто держал камеру: плавный наезд, панорама, таймлапс. Формат тоже выбираете под площадку, горизонтальный для YouTube или вертикальный для соцсетей. Перед публикацией прогоните результат дважды, мелкие надписи и логотипы в кадре модель иногда перерисовывает. И да, простые запросы дают нестабильный результат, а подробное описание сцены держит картинку в рамках.
Что понравилось
- Дорожка синхронизирована с действием, отдельный монтаж звука не нужен.
- Понимает термины видеосъемки: наезд, панорама, таймлапс.
- Разрешение от 720p до 4K, есть горизонтальный и вертикальный формат.
- Оживляет статичные фото, сохраняя исходный объект.
Что стоит учесть
- Мелкие детали, текст и логотипы в кадре иногда искажаются.
- Часть моделей на платформе работает бесплатно, но в общей очереди.
4. Kling
Аудиодорожку здесь собирают вместе с картинкой: в версии 4.0 заявлена синхронизация звука с действием и стабильная динамика движения. Ролик длится секунды, но за счет нативной генерации в 4K мелкие фактуры вроде ткани или бликов на воде сохраняются. Помимо генератора по тексту работает холст с узловым редактированием: сценарий, раскадровка, видео и постпродакшен живут в одном проекте. Агент берет на себя черновики, вы правите узлы и пересобираете версию за версией. Начните с короткой сцены на 5-8 секунд, так проще поймать, как модель держит движение камеры и речь персонажа. Дальше уже наращивайте длину и усложняйте действие.

Что понравилось
- Звук синхронизирован с картинкой на этапе генерации.
- Нативное разрешение до 4K с проработкой мелких текстур.
- Холст с узловым редактированием и агентом для раскадровок.
- Кейсы уровня фестивальных короткометражек, рекламы и полнометражного фильма на 135 минут.
- Есть MCP и CLI для пакетной генерации сразу нескольких версий.
Что стоит учесть
Сложный сюжет требует дробления на отдельные сцены.
Перейти на сайт сервиса >>>5. Sindikat AI
Каталог моделей здесь устроен как общий пульт: под одной подпиской открываются десятки нейросетей, от текстовых до видеогенераторов. Для работы со звуком интересны Seedance, который собирает короткие ролики из референсов или описания, и Google Veo с выдачей до 4K. Рядом стоят Kling с поэтапными правками и MiniMax с точным управлением кадром. Совет от меня: не гонитесь за всеми моделями сразу, выберите две под свою задачу и сравните, как каждая держит речь персонажа и фоновый гул сцены. Кредиты расходуются за запуск, поэтому черновики лучше гонять на быстрых версиях, а финал собирать на старших.

Что понравилось
- Больше 25 моделей в одном окне, включая видеогенераторы с синхронизированным звуком.
- Видео до 4K и фото до 4K в рамках одной подписки.
- Кредиты на старших тарифах дешевле на 10-30 процентов.
- Оплата российскими картами и через СБП, отмена подписки в один клик.
- Пробный доступ на 7 дней за 299 рублей с полным набором функций.
Что стоит учесть
- При интенсивной работе с дорогими видеомоделями кредитов хватает ненадолго.
- Тариф Pro дает 800 кредитов в месяц, это примерно 7 видео.
6. Happy Horse
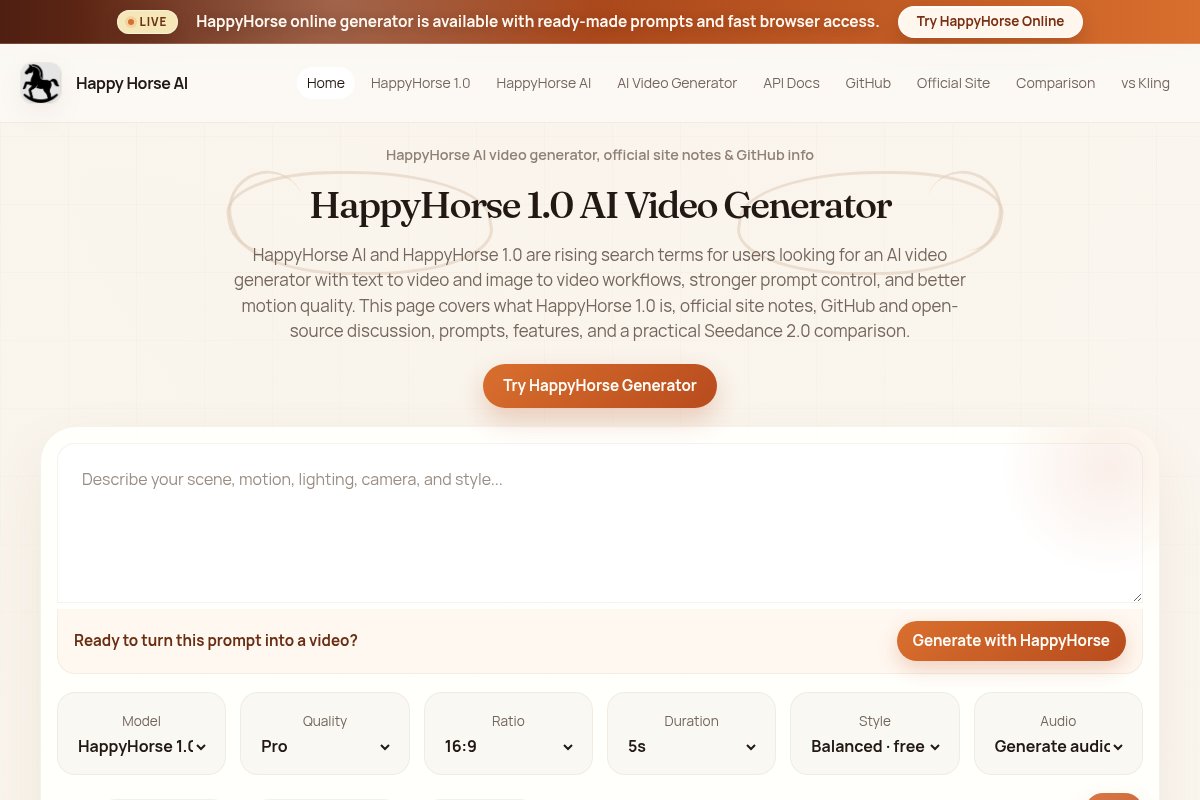
Ролик здесь собирается по текстовому промпту, а референсы задают стиль и композицию кадра. Логика простая: описываете сцену, добавляете опорные файлы, запускаете генерацию и получаете готовое видео. Стоимость считают по секундам, а не фиксированной подпиской, поэтому длинные сцены обходятся дороже коротких. Перед запуском продумайте, что именно должно звучать в кадре, и опишите речь, музыку и окружающий шум прямо в промпте. Тогда дорожку потом придется править меньше.
Что понравилось
- Генерация по промпту с опорой на референсы.
- Оплата по секундам: платите за фактическую длину ролика.
- Порядок работы из трех шагов, без лишних настроек.
Что стоит учесть
Цена растет вместе с длительностью сцены.
Перейти на сайт сервиса >>>7. Grok Imagine
Пятнадцать секунд это весь формат, и для соцсетей такой отрезок закрывает задачу целиком. Модель принимает текст или картинку, а на выходе получаете реалистичную динамику с кинематографичным движением камеры и естественной физикой объектов. Звук здесь синхронизирован с действием, и в настройках генерации есть отдельный параметр аудио: его стоит проверить до запуска, а не после. Мой совет такой: сначала прогоните черновик в младшей версии модели, послушайте, как звучит речь и фоновый слой, и только потом переключайтесь на старшую. Так кредиты уйдут на осмысленные попытки, а не на перебор вариантов наугад.
Что понравилось
- Ролики до 15 секунд, формат заточен под вертикальные площадки.
- Дорожка синхронизируется с картинкой в момент генерации.
- В параметрах генерации есть отдельный переключатель аудио.
- Работает и по тексту, и по загруженному изображению.
- В каталоге доступны две версии модели, базовая и 1.5.
Что стоит учесть
- Кредиты списываются за каждый запуск, даже если результат вышел с ошибкой.
- Ограничение в 15 секунд не обойти без склейки нескольких сцен.
- Длинные промпты модель трактует вольно, мелкие детали кадра стоит описывать точечно.
8. Beeble AI
Отдельная ветка в работе с видео: кадр уже снят, а фон и свет в нем не устраивают. Сценарий, который здесь сильнее всего заходит, выглядит так: вы загружаете готовый материал, меняете локацию или время суток в кадре и получаете дубль без повторной съемки. Дальше картинка уходит на дорожку, где решается, какая речь звучит и как ложится фоновый слой. Я бы посоветовала сначала привести сцену к нужному настроению, а уже потом браться за озвучку и музыку.

Почему стоит выбрать
- Меняет фон и освещение в уже отснятом видео.
- Снимает необходимость ездить на повторные съемки ради другой локации.
Что стоит учесть
- Синтезом звука сервис не занимается, дорожку добавляют в другом месте.
- Размытые и темные фрагменты кадра обрабатываются хуже.
9. Dreamina
Текстовое описание превращается в короткий клип, и это базовый сценарий работы. Вы пишете, что должно быть в кадре, выбираете формат под площадку и запускаете генерацию. Сервис тянет в сторону коротких динамичных сцен, которые хорошо смотрятся в ленте. Лучше сразу готовьте текст под вертикальный кадр, иначе композиция при обрезке развалится. И не забудьте отдельно прописать, что звучит в видео: речь, музыку или уличный шум.
Что понравилось
- Генерация по текстовому описанию, без сложных настроек.
- Шаблоны под короткие форматы для соцсетей.
- Работает и с изображениями, не только с видео.
Что стоит учесть
- Длинные сцены приходится дробить на несколько фрагментов.
- Детали кадра модель трактует по-своему, промпт стоит уточнять.
10. RANVIK
Моделей для видео здесь собрано около десятка: Sora, Veo, Kling, Runway, Luma, PixVerse, Wan, Vidu, Seedance и другие стоят рядом в одном каталоге. Ролик собирается по тексту, по загруженному фото или по музыкальному треку, а на выходе получаете движение камеры и атмосферный звук. В описании сервиса отдельно упомянуты озвучка, музыка и эффекты, то есть дорожку можно закрыть в том же окне, где родилась картинка. Советую начать с бесплатного режима и короткой сцены на пару секунд: так вы увидите, какая модель точнее держит ваш тип кадра. Дальше переходите на платный тариф и усложняйте задачу.

Почему стоит выбрать
- Около десятка видеомоделей в одном каталоге, включая Seedance и Runway.
- Генерация по тексту, фото и музыке, с озвучкой и эффектами.
- Бесплатная пробная генерация в базовом режиме.
- Работает в браузере, а также на Android и iOS.
- Есть готовые подборки трендов, если нужна идея для старта.
Что стоит учесть
- Тестовые сутки стоят 390 рублей, неделя 590, месяц 1390, год 8900.
- Суточный лимит 500 000 токенов, дополнительные покупаются отдельно.
11. GPTunneL
Главное преимущество — возможность наложить звук на видео во встроенном редакторе «Воркфлоу», не переходя в отдельную программу для монтажа. Вы можете создать голосовую озвучку по тексту, сгенерировать музыку или звуковые эффекты, а затем объединить их с видеорядом на монтажной шкале. Редактор позволяет управлять громкостью, обрезать фрагменты, добавлять титры и менять формат ролика. Для генерации видео со звуком доступны Kling, Veo, Sora и другие модели. Начните с короткого ролика и простой озвучки, проверьте синхронизацию звука с изображением, а затем добавьте музыку и дополнительные эффекты.

Почему стоит присмотреться
- Наложение звука и озвучки на видео во встроенном редакторе.
- Генерация музыки, речи и звуковых эффектов с помощью ИИ.
- Регулировка громкости и работа с аудио- и видеодорожками.
- Доступ к нескольким видеомоделям в одном сервисе.
Что стоит учесть
- Редактирование изображения через VideoEdit стоит 50 рублей за секунду.
- Обработка фрагмента ограничена 2–30 секундами.
Что на самом деле происходит со звуком
Стоит разделить два разных сценария, которые часто путают. Первый: модель генерирует видео с нуля и сразу собирает дорожку вместе с картинкой. Второй: ролик уже снят, и вы хотите наложить звук на видео с помощью ИИ отдельным слоем. Это разные задачи, и инструменты под них отличаются.
В первом случае синхронизация заложена в архитектуру. Видео и аудио проходят через отдельные кодировщики, но собираются в едином временном блоке. Проще говоря, модель знает, что на третьей секунде персонаж открывает рот, и подставляет реплику именно туда, а не сдвигает ее на полсекунды позже. Такой подход экономит самый нервозный этап работы.
Во втором случае вы работаете поверх готового материала. Загружаете файл, описываете, что должно звучать, и ждете результата. Здесь многое зависит от исходника: чистый кадр без грохота ветра дает предсказуемый результат, а запись с перегруженным микрофоном придется сначала почистить.
Что умеют современные модели
Список возможностей за последний год заметно вырос, и в нем легко запутаться. Я свел основные сценарии, с которыми сталкиваюсь чаще всего.
- Генерация реплик и диалогов. Модель расставляет речь персонажей по таймлайну и подбирает интонацию под действие в кадре.
- Создание фонового слоя. Шум улицы, гул офиса, шелест листвы, гул стадиона: все это описывается словами и появляется вместе с картинкой.
- Музыкальное сопровождение. Трек подбирается под ритм монтажа, а не приклеивается поверх готовой склейки.
- Добавление эффектов: скрип двери, удар, взрыв, звук шагов по гравию.
- Улучшение готовой дорожки. Отдельная ветка, где ИИ-улучшение звука на видео убирает гул, выравнивает громкость и подчищает провалы.
Последний пункт недооценивают. Иногда чище и быстрее почистить существующую запись, чем собирать новую с нуля. Я проверяю оба пути почти на каждом проекте и не всегда выбираю генерацию.
Как писать промпт, чтобы дорожка получилась живой
Здесь работает то же правило, что и с картинкой: чем конкретнее описание, тем меньше сюрпризов. Размытое пожелание вроде «атмосферный звук» модель трактует как хочет. Сухое перечисление слоев дает предсказуемый, но стерильный результат.

Старайтесь описывать сцену во времени, а не только в первом кадре. Что меняется к концу ролика: нарастает гул, стихает ветер, персонаж переходит с шепота на крик. Отдельно проговаривайте, какой язык звучит в репликах и нужны ли субтитры. И не забудьте про соотношение сторон: вертикальный кадр под соцсети компонуется иначе, и звук в нем живет по другим правилам.
Мой рабочий шаблон выглядит примерно так: сначала действие, потом камера, потом звуковой слой. Три блока, каждый по одному предложению. Такой промпт читается моделью без конфликтов, и я реже ловлю ситуацию, когда диалог перекрывает музыку.
Где обычно спотыкаются
Первая проблема: рассинхрон на длинных сценах. Чем длиннее ролик за один проход, тем сложнее модели удержать согласованность движения и звука по всей длине. Лечится дроблением на короткие фрагменты с последующей склейкой.
Вторая: перегруз деталями. Когда в промпте одновременно пять источников шума и три реплики, модель начинает путаться. Я оставляю два-три слоя максимум.
Третья: текст и логотипы в кадре. Модели любят перерисовывать мелкие надписи, и вместе с ними плывет все остальное. Если в кадре есть вывеска или титр, проверьте его после генерации.
Четвертая, самая обидная: кредиты списываются за запуск, даже если результат вышел с браком. Держите это в голове и не гоняйте дорогие модели на черновиках.
Чек-лист перед запуском
- Сцена разбита на короткие фрагменты, каждый не длиннее лимита выбранной модели.
- В промпте отдельно описаны действие, камера и звуковой слой.
- Указан язык реплик и необходимость субтитров.
- Проверено, есть ли в настройках отдельный параметр аудио.
- Для черновика выбрана быстрая версия модели, для финала основная.
Этот список занимает минуту, а экономит куда больше. Я держу его под рукой, когда переключаюсь между сервисами и легко забываю, что именно уже настроил.
Сколько это стоит и на что рассчитывать бесплатно
Разброс цен большой. Часть платформ считает по секундам готового ролика, часть работает на подписке с внутренними токенами, часть дает пробные сутки за символическую сумму. Есть и бесплатный вход: несколько генераций в сутки, ограниченный набор моделей или общая очередь запросов.
Совет простой: начните с бесплатного режима и одной короткой сцены. Так вы увидите, как конкретная модель держит ваш тип кадра, и не потратите деньги на перебор вслепую. Платный тариф подключайте, когда поймете, что именно вам не хватает: длины ролика, разрешения или доступа к конкретной модели.
И последнее. Автоматизация снимает рутину, но не отменяет вкуса. Финальную сборку, громкость и баланс между речью и музыкой все равно проверяет человек. Модель предлагает черновик, а решение остается за вами.
Вопросы, которые всплывают чаще всего
Тему обсудили, сервисы разобрали, но часть вопросов остается за кадром. Собрал те, что чаще всего приходят мне в личку после подобных обзоров. Отвечаю коротко, без воды.
Можно ли улучшить звук на ИИ-видео, если запись уже испорчена?
Да, и это отдельная ветка работы. Модель вычищает гул, выравнивает громкость и подтягивает провалы, но чудес не показывает: восстановить чистые частоты не выйдет. Поможет чистка, а не полная перезапись.
Как наложить звук на видео через ИИ, когда ролик давно снят?
Загружаете файл в сервис, описываете словами, что должно звучать, и запускаете генерацию дорожки. Дальше проверяете синхронизацию вручную и правите стыки. На длинных сценах лучше резать материал на короткие фрагменты.
Можно ли добавить звук на видео нейросетью без подробного промпта?
Формально справится, но результат выйдет пресным. Модель подставит что-то нейтральное вместо конкретной атмосферы. Чем точнее описание сцены, тем меньше правок после генерации.
Насколько точно ИИ-звук на видео попадает в движение губ?
В моделях, где дорожка рождается вместе с картинкой, попадание близкое к точному. При наложении поверх готового ролика возможен сдвиг на доли секунды. Такие стыки я всегда просматриваю покадрово.
Что дешевле: генерация с нуля или чистка старой дорожки?
Зависит от исходника. Чистый кадр быстрее сгенерировать заново, а перегруженную запись выгоднее почистить. Проверяйте оба пути на коротком фрагменте, прежде чем запускать полную версию.
Хватит ли бесплатного режима, чтобы попробовать?
Для первой пробы хватает. Ограничения обычно касаются числа генераций, набора моделей или очереди запросов. Одной короткой сцены достаточно, чтобы понять, как конкретная модель держит ваш тип кадра.
Начинать стоит с малого: одна короткая сцена, бесплатный режим и понятная задача вроде реплики персонажа или уличного шума за кадром. При выборе смотрите на три вещи: есть ли отдельный параметр аудио, сколько длится ролик за один проход и на каком языке звучат реплики. Дальше решайте, что удобнее в работе именно вам: генерация с нуля или чистка готовой дорожки. И помните, что нейросеть добавляет звук в видео лишь черновиком, а финальный баланс между речью и музыкой все равно проверяет человек.
Теперь слово вам. Расскажите в комментариях, какими сервисами пользуетесь и что в них оказалось удобнее на практике.
* Meta Platforms Inc. (и принадлежащие ей соц.сети Instagram, Facebook) признана экстремистской организацией, ее деятельность в России запрещена.

Крч недавно видео сняла, смонтировала, а звук ну трееш. Речь еле слышно. Пробовала чистить вручную, но это ад. с иишкой уже совсем другое дело. Подскажите, а с какого сервиса лучше начать, если хочется просто убрать шум и добавить музыку?