



Топ-5 сервисов, запускающих нейросеть Kimi K 2.6 в 2026 году

Оплата за токены, без подписки.
Минимальное пополнение — 50 ₽.
- Переключение между 200+ нейросетями внутри одного диалога;
- внесена в реестр отечественного ПО;
- калькулятор стоимости запроса прямо в интерфейсе.

Оплата за токены — 1,44 ₽/1K.
Стартовый бонус при регистрации (~20 запросов).
- 80+ готовых сценариев: диаграммы, графики, разбор файлов;
- поддержка командного счета для группы пользователей;
- бот в Telegram и ВКонтакте.
Безлимитные ключи от 220 ₽/мес.
Пополнение API-баланса от 4 ₽ (1 USD = 7,99 ₽).
- Маркетплейс цифровых товаров с автоматической выдачей 24/7;
- 10 параллельных потоков на безлимитном тарифе;
- привычная оплата картой МИР или через СБП.

Оплата за токены, без абонентской платы.
Стартовый баланс для новых пользователей.
- Единый API-ключ на десятки моделей с документацией на русском;
- встроенный перевод запроса одним параметром;
- чат-интерфейс СигмаЧат для тех, кто не пишет код.

Бесплатно 30 000 Caps.
Платные пакеты от $3 (Caps не сгорают по времени).
- Шифрование диалогов AES-GCM;
- доступ через веб, мобильное приложение и Telegram-бот;
- бесплатный обучающий курс «Академия BotHub».
Kimi 2.6 — обзор модели изнутри: от архитектуры до готовых промптов
Сервис выбран, доступ настроен — самое время разобраться, что именно вы получаете. Ниже — детализированный разбор: архитектурные отличия K2.6 от предыдущих версий, практические приемы для работы с длинным контекстом и агентным режимом, а также готовые промпты, которые стоит попробовать в первую сессию.
Kimi K 2.6: обзор отличий от предыдущих версий
Линейка Moonshot AI обновляется стремительно: K2 появилась как базовая open-source модель с MoE-архитектурой, K2 Thinking добавила режим «цепочки рассуждений», а K2.5 расширила агентные возможности. Kimi K 2.6 AI — следующий шаг, и разница по сравнению с предшественниками ощущается не в синтетических тестах, а в повседневной работе.
Что изменилось по существу
Длинный контекст стал стабильнее. Окно по-прежнему 256 тысяч токенов, но стабильность удержания контекста выросла на 18% относительно K2.5. На практике это значит, что модель реже «забывает» условия из начала объемного документа, когда вы просите переработать финальный раздел.
Агентный режим масштабировался. В K2.5 Agent Swarm координировал до 100 субагентов и 1 500 последовательных шагов. В K2.6 — до 300 субагентов и 4 000 шагов за один автономный запуск. Успешность вызова инструментов достигла 96,6%. Модель способна работать в фоновом режиме 12 и более часов, итерируя решение без потери содержательной нити.
Код вышел на уровень лидеров. На SWE-Bench Pro модель набирает 58,6 — выше, чем Claude Opus 4.6 (53,4) и Gemini 3.1 Pro (54,2). В рамках внутреннего бенчмарка Moonshot прирост относительно K2.5 составил 15%. Модель уверенно работает с Rust, Go, Python и даже нишевыми языками вроде Zig.
Мультимодальность осталась внутренней. Визуальный энкодер MoonViT на 400 млн параметров обрабатывает изображения, но через API картинки подать напрямую пока нельзя — Vision используется моделью «под капотом» для задач, связанных с Code-Driven Design. Это стоит учитывать, если вы планируете выполнять анализ скриншотов или фотографий.
Где K2.6 уступает. В чистой математике GPT-5.4 по-прежнему впереди (99,2 против 96,4 на AIME 2026). Скорость генерации — 48 токенов в секунду против 116 у K2 Thinking: за отточенность ответов приходится платить временем. И контекстное окно у ряда моделей сегодня уже достигает 1 млн токенов — при работе с действительно гигантскими корпусами это ограничение чувствуется.
В каких задачах K2.6 раскрывается эффективнее всего
Абстрактные бенчмарки мало говорят о том, где модель пригодится лично вам. Вот четыре сценария, в которых K2.6 отрабатывает заметно увереннее большинства альтернатив этого класса — проверено на реальных рабочих ситуациях.
Разработка с длинным горизонтом. Если вы поддерживаете проект, которому больше года, и кодовая база разрослась до десятков тысяч строк — K2.6 справляется с ролью «второго разработчика». Загружаете репозиторий, описываете проблему, и модель не просто предлагает точечную заплатку, а выстраивает план изменений с учетом зависимостей между модулями. Особенно заметна разница на рефакторинге: там, где другие нейросети теряют контекст после третьего файла, K2.6 продолжает держать общую архитектуру в голове.
Работа с объемными текстами. Юридические договоры, техническая документация, исследовательские отчеты — все, что занимает больше 50 страниц. Вы загружаете полный текст и просите найти противоречия, извлечь ключевые условия или переписать раздел с сохранением логики остального документа. Модель не перескакивает и не выдумывает содержание непрочитанных страниц — она действительно их «видит».
Контент-задачи с жесткими ограничениями. Серия постов в едином тоне, адаптация текста под разные площадки, рерайт с сохранением структуры аргументации — везде, где важна последовательность на длинной дистанции. K2.6 помнит Tone of Voice из начала диалога, даже если вы вернулись к задаче через двадцать сообщений.
Аналитика и исследования. Сбор информации по теме, сравнение источников, подготовка структурированного отчета — задачи, где агентный режим включается в полную силу. Модель разбивает вопрос на подзадачи, прорабатывает каждую, сверяет выводы между собой и собирает финальный документ. Это не замена глубокого экспертного анализа, но черновик получается плотным и логически связным.
Чего от K2.6 ожидать не стоит
Честность по поводу ограничений экономит время и нервы — поэтому вот список ситуаций, в которых стоит либо выбрать другую модель, либо скорректировать оптимизм ожиданий.
Мгновенные ответы на простые вопросы. Если задача — быстро получить определение, пересчитать единицы или сгенерировать короткий текст в пару предложений, K2.6 избыточна. Она «думает» дольше легковесных моделей, и эта задержка не окупается на мелких запросах. Для таких вещей DeepSeek V4 Flash или GPT-5.6 Luna отработают быстрее и дешевле.
Прямой анализ изображений через API. Визуальный энкодер есть, но подать картинку на вход через API-запрос пока нельзя. Если задача связана с разбором скриншотов, фотографий или инфографики — Claude или Gemini закроют ее напрямую, а K2.6 — нет.
Олимпиадная математика на максимальном уровне. Модель сильна в рассуждениях, но на задачах уровня AIME 2026 GPT-5.4 стабильнее. Если вы готовитесь к математической олимпиаде или строите систему, где критична абсолютная точность вычислений, — это не основной профиль K2.6, присмотритесь к альтернативным ИИ.
Работа дисциплины в промптах. Небрежный запрос из трех слов даст размытый ответ. K2.6 вознаграждает за четкость инструкции, но не прощает лени при формулировании вопроса. Если вы привыкли писать «ну, сделай красиво» — модель не угадает, что именно вы имели в виду.
Практический обзор: как получить максимум от Kimi 2.6
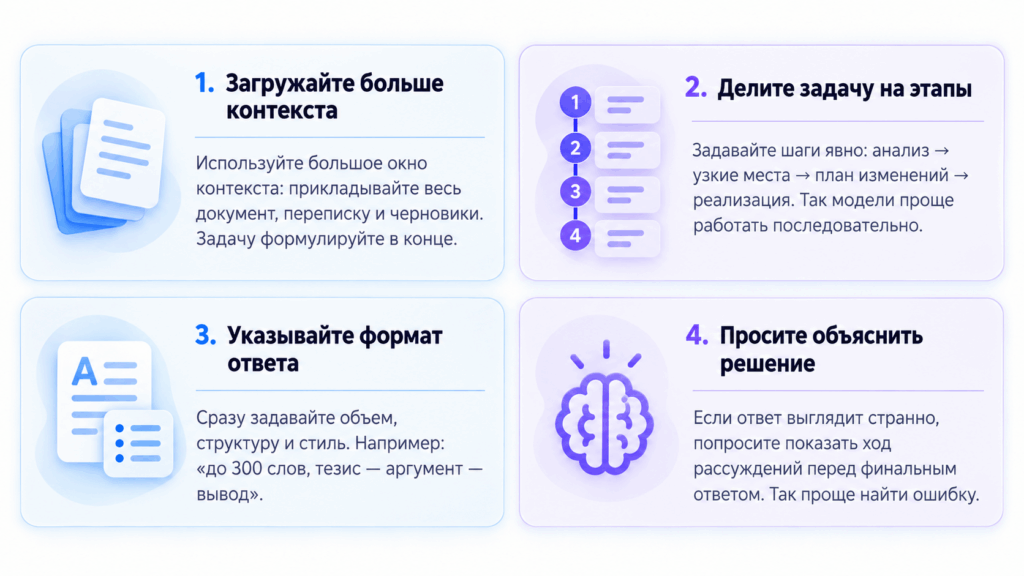
Раз модель вознаграждает за четкость формулировки — вот конкретные приемы, которые работают именно с K2.6 и помогают экономить и токены, и итерации. Несколько принципов, проверенных на практике.
Загружайте контекст «с запасом». Раз окно вмещает 256K токенов, не стесняйтесь прикладывать к запросу весь документ, а не выжимку. Kimi AI 2.6 лучше справляется, когда видит полную картину, чем когда получает фрагмент без окружения. Вставляйте ТЗ, переписку, черновики, справочные материалы — и формулируйте задачу в конце, после всего блока данных.
Разбивайте сложные задачи на этапы явно. Агентный режим хорош, но ему помогает четкая дорожная карта. Вместо «сделай рефакторинг проекта» эффективнее: «Шаг 1 — построй карту модулей. Шаг 2 — выдели узкие места. Шаг 3 — предложи план изменений. Шаг 4 — реализуй первый модуль». Модель воспринимает такие инструкции как Pipeline и распределяет ресурсы последовательно.
Указывайте формат вывода. K2.6 охотно генерирует длинные тексты — иногда слишком длинные. Фраза «ответ в пределах 300 слов, структура: тезис — аргумент — вывод» сокращает итерации и экономит токены.
Просите модель объяснить свои решения. В режиме thinking K2.6 раскладывает цепочку рассуждений. Если вы видите странный результат — добавьте «покажи ход рассуждений перед финальным ответом». Часто проблема обнаруживается на промежуточном шаге, и ее проще скорректировать там, чем переформулировать весь запрос.
Kimi K 2.6 и Code: промпты для разных задач
Ниже — пять готовых промпта, каждый демонстрирует отдельную сильную сторону модели. Структура намеренно различается: от лаконичной команды до развернутого пайплайна.
1. Глубокий разбор кодовой базы (агентный режим, long horizon)
Передо мной репозиторий на Python (~12 000 строк). Задача:
1. Построй карту зависимостей между модулями.
2. Найди циклические импорты.
3. Выдели три самых связанных компонента — кандидатов на вынос в отдельный пакет.
4. Для каждого кандидата предложи план рефакторинга с минимальным количеством изменений в остальном коде.
Формат: markdown-отчет с диаграммой зависимостей в mermaid-синтаксисе.
2. Аналитика длинного документа (long context)
Ниже — текст договора аренды (47 страниц). Найди все пункты, которые:
а) дают арендодателю право на одностороннее расторжение;
б) содержат штрафные санкции для арендатора;
в) противоречат друг другу.
Ответ оформи таблицей: номер пункта | краткое содержание | тип (a/b/c) | цитата.
3. Креативная задача с контролем стиля
Напиши пять вариантов заголовка для лендинга онлайн-школы иллюстрации. Условия: не длиннее 8 слов каждый, без восклицательных знаков, тон — спокойная уверенность, аудитория — взрослые с опытом, метафоры приветствуются. После заголовков — объяснение логики каждого варианта одним предложением.
4. Пошаговый пайплайн для DevOps (agent swarm, multi-step)
Задача: настроить CI/CD-пайплайн для монорепозитория на Go (3 сервиса + общая библиотека).
Шаг 1 — проанализируй структуру репозитория и определи границы каждого сервиса.
Шаг 2 — напиши GitHub Actions workflow: линт, тесты, сборка Docker-образа.
Шаг 3 — добавь условие: пересобирать только те сервисы, файлы которых изменились в PR.
Шаг 4 — протестируй workflow на трех сценариях (изменение в одном сервисе, в общей библиотеке, в двух сервисах одновременно).
Для каждого шага покажи промежуточный результат перед переходом к следующему.
5. Итеративная доработка текста с фиксированной ролью
Твоя роль — редактор деловой переписки с опытом в B2B-продажах.
Вот письмо клиенту (ниже). Задача:
1. Оцени текущий текст по трем критериям: ясность, убедительность, длина.
2. Предложи переработанную версию — не длиннее 150 слов, без канцеляризмов, с одним четким призывом к действию.
3. Объясни в двух предложениях, что изменил и почему.
Если я отвечу «ближе к оригиналу» или «смелее» — скорректируй в указанном направлении, сохраняя формат ответа.
Сильная сторона K2.6 — не отдельная фича, а сочетание: длинный контекст, агентная выносливость и уровень кода, с которым уже неловко сравнивать прошлогодние релизы. Модель не универсальна: в чистой математике и скорости генерации есть соперники покрепче, а контекстное окно пока уступает миллионникам. Но для задач, где важна глубина погружения в материал и способность тянуть проект часами без потери сюжетной нити, Кими 2.6 оказывается неожиданно зрелым выбором. Попробуйте Kimi на чем-то настоящем — длинном документе, запутанном репозитории, цепочке правок, которую вы обычно делаете за полдня, — и выводы сложатся сами.
Если вы уже тестировали модель — расскажите в комментариях, на какой задаче она вас удивила или, наоборот, разочаровала. Такие живые кейсы полезнее любого бенчмарка.




У меня нейросети обычно начинают путаться, когда загружаю большой договор и потом несколько раз прошу внести правки. Судя по статье, кими ии как раз лучше держит длинный контекст, попробую на следующем доке.