

ETL расшифровывается как Extract, Transform, Load: извлечение, преобразование, загрузка. Этот подход помогает объединить записи из учетных систем и подготовить их для отчетности, аналитики или других задач. Вместо ручной сверки компания получает повторяемую процедуру с заданными правилами.
Например, интернет-магазин хранит заказы в CRM, платежи в бухгалтерской программе, а расходы на рекламу в кабинетах рекламных платформ. ETL-процесс связывает эти записи, приводит суммы и даты к обжнему формату и рассчитывает показатели продаж. При этом сама технология не определяет, что бизнес считает выручкой: эти правила команда согласует заранее.
Чем ETL-процесс может отличаться от ETL-системы
Процесс описывает последовательность действий:
- откуда поступают записи,
- какие проверки они проходят
- и куда попадают после подготовки.
Система дает технические средства для этих действий:
- коннекторы,
- редактор логики,
- планировщик
- и журнал выполнения.
Команда может реализовать такую цепочку с помощью SQL, Python и планировщика задач, без отдельной платформы. Готовый механизм сокращает объем собственного кода, но не заменяет проектирование: даже удобный визуальный интерфейс не исправит неверную формулу расчета выручки.
Как работать с ETL: от извлечения до загрузки
Классическая схема состоит из трех последовательных операций. Сначала механизм получает записи, затем проверяет и меняет их, после чего передает результат в целевую систему.
Эти операции образуют ETL-пайплайн, то есть связанную цепочку действий. Ошибка в начале влияет на итог, поэтому разработчики задают условия перехода между операциями и правила остановки при сбоях.
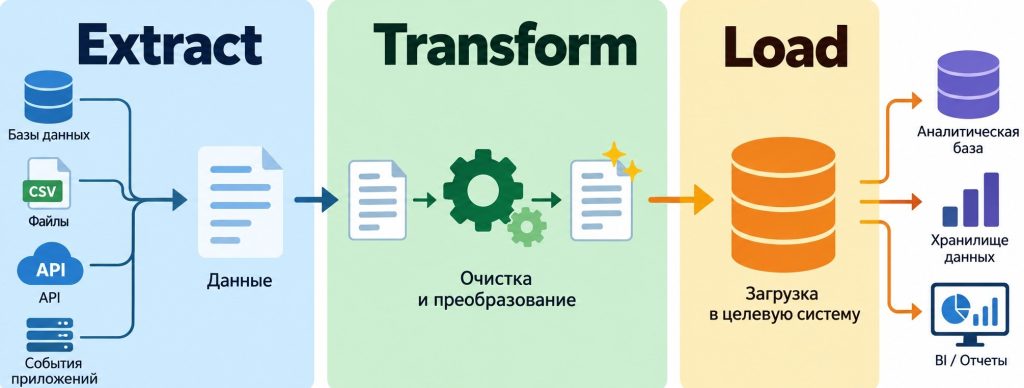
Extract: извлечение из баз, файлов, API и других источников
На этом этапе коннекторы читают таблицы баз, файлы CSV, ответы API или события приложений. Способ подключения зависит от возможностей системы: база поддерживает SQL-запросы, сервис предоставляет API, а партнер передает ежедневный файл.
Полная выгрузка копирует весь выбранный набор записей. Инкрементальная передает только изменения, например по времени обновления или через CDC, механизм отслеживания изменений в базе. Второй подход снижает нагрузку, но требует учета удалений и контроля пропущенных обновлений.
Transform: очистка, объединение и преобразование
Здесь преобразование приводит записи к согласованным правилам. Скрипт исправляет типы полей, нормализует даты, сопоставляет идентификаторы клиентов и отделяет ошибочные строки от корректных.
Проверки не должны незаметно менять смысл показателей. Например, замена пустой цены на ноль исказит выручку, а удаление похожих заказов без проверки идентификаторов скроет реальные покупки. Инструкция заранее определяет, какие ошибки допускают автоматическое исправление, а какие требуют разбора.
Load: загрузка в целевую систему
Финальная операция записывает результат в аналитическую базу или другую целевую систему. Разработчики выбирают стратегию: полностью заменить таблицу, добавить новые строки либо обновить существующие записи по ключу.
Особое внимание требует история изменений. Если клиент сменил регион, текущая карточка покажет новое значение, но отчет за прошлый год может требовать прежнее. Для таких случаев модель сохраняет версии и периоды их действия.
Как устроена архитектура
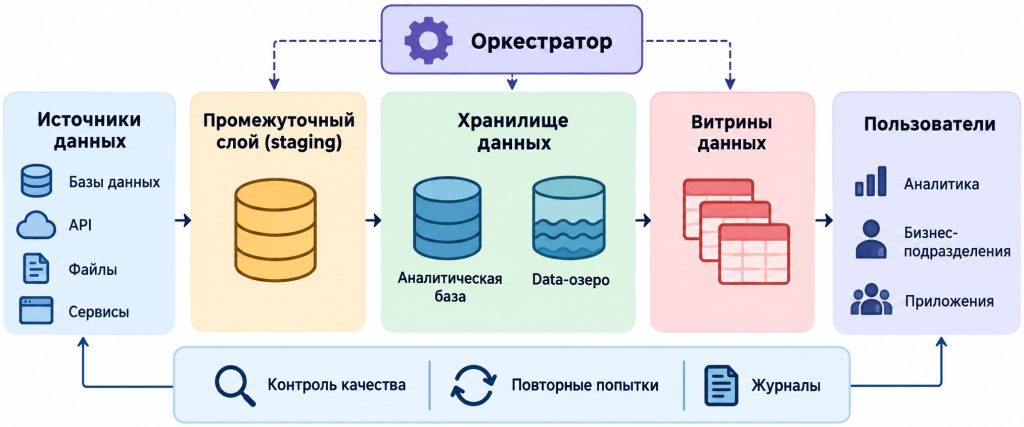
Архитектура описывает не только маршрут, но и связи между компонентами. Она определяет, где выполняется код, как система хранит промежуточные результаты и кто отвечает за запуск зависимых задач.
Небольшому проекту бывает достаточно нескольких скриптов и базы. По мере роста нагрузки команда разделяет прием, вычисления, контроль качества и публикацию результатов, чтобы сбой отдельного компонента не останавливал всю цепочку.
Источники, промежуточный слой и управление потоками
Каждый источник задает свои ограничения: лимиты API, доступное время выгрузки, структуру полей и допустимую нагрузку. Промежуточный слой, или staging, сохраняет полученные записи перед дальнейшими операциями. Такая копия помогает повторить расчет без нового обращения к внешней системе.
Оркестратор отвечает за управление зависимостями: запускает задачи в нужном порядке, отслеживает завершение и повторяет неудачные попытки. Например, расчет выручки стартует только после успешного обновления заказов и платежей, а не просто в назначенное время.
Хранилище, data-озеро и витрина: какую роль они играют
Аналитическая база обычно содержит согласованные таблицы с понятной структурой и связями. Озеро (data lake) сохраняет большие массивы в исходном или близком к исходному виде: файлы, журналы событий, изображения. Витрина предоставляет подготовленный набор под конкретную задачу, например анализ продаж.
Эти компоненты не исключают друг друга. Компания может сохранять исходные файлы в озере, формировать общую аналитическую модель и публиковать тематические витрины для отделов. Выбор зависит от запросов, объема и требований к скорости доступа.
Пакетная и потоковая обработка: как выбрать режим работы
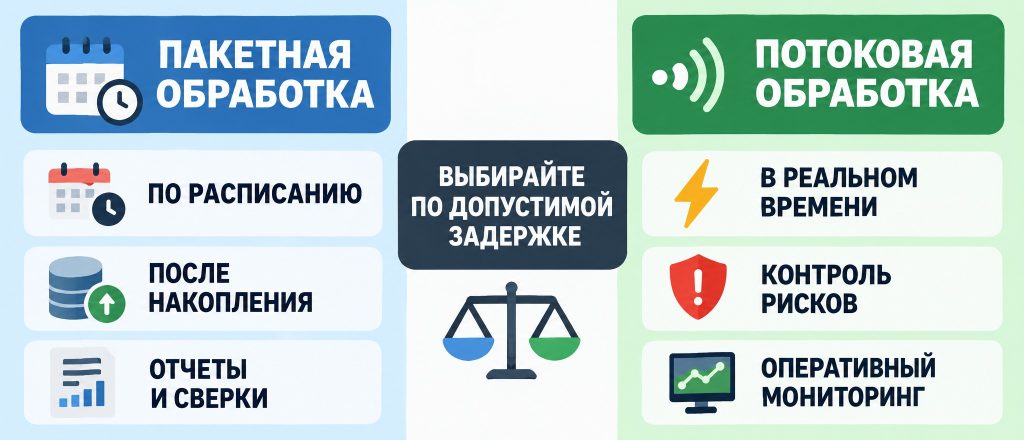
Пакетная обработка запускается по расписанию или после накопления определенного объема записей. Такой режим подходит для ежедневной отчетности, сверки платежей и пересчета показателей за закрытый период.
Потоковая схема принимает события по мере поступления и сокращает задержку между действием пользователя и реакцией системы. Она полезна для контроля подозрительных операций и оперативного мониторинга, но усложняет учет опоздавших событий, повторов и нарушенного порядка сообщений.
Команда выбирает режим по допустимой задержке, а не по привлекательности технологии. Если менеджеры открывают отчет утром, еженочная загрузка часто закрывает задачу без затрат на непрерывную инфраструктуру. Для реакции на подозрительный платеж через несколько секунд пакетного обновления недостаточно.
Потоковый режим не меняет автоматически порядок операций. В сравнении ETL и ELT решающим остается место вычислений: первый подход готовит записи до помещения в целевую аналитическую систему, а второй переносит туда исходные записи и выполняет вычисления внутри нее.
Где применяют ETL: примеры из разных отраслей
Компании обращаются к этому подходу, когда отдельные приложения показывают лишь часть общей картины. Связанные записи помогают проверить показатели между подразделениями и сократить ручные сверки.
Отрасль определяет требования к точности, скорости обновления и защите информации. Для финансового отчета важна воспроизводимость расчета, а для оперативного контроля доставки критична свежесть статусов.
Финансы и торговля: отчетность, продажи и анализ клиентов
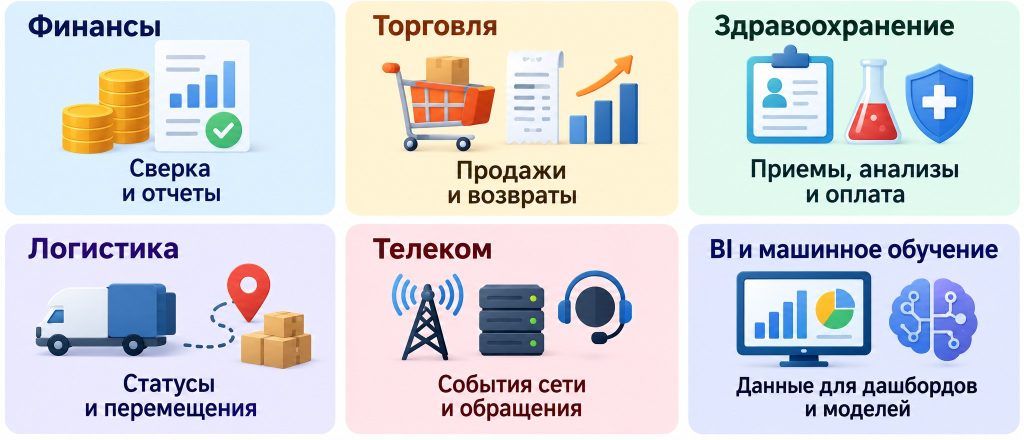
В финансах такие процессы объединяют транзакции, сведения о договорах и бухгалтерские проводки для сверки и подготовки отчетов. Контрольные суммы помогают обнаружить расхождения до публикации итоговых показателей.
В торговле команда может собирать заказы, возвраты, остатки и рекламные расходы в общую модель. Показательный пример: отчет связывает рекламную кампанию не только с покупками, но и с последующими возвратами. Так бизнес оценивает результат по согласованной метрике, а не только по сумме оформленных заказов.
Здравоохранение, логистика и телеком: объединение сведений из разных систем
В здравоохранении интеграционная цепочка связывает сведения о приемах, лабораторных исследованиях и оплате услуг при соблюдении правил доступа. Особую сложность создает сопоставление пациентов: совпадение имени само по себе не подтверждает, что записи относятся к одному человеку.
Логистические компании объединяют статусы отправлений, складские операции и координаты транспорта. Телеком-операторы сопоставляют технические события с обращениями абонентов, чтобы искать причины ухудшения качества связи.
Подготовка выборок для BI-аналитики и машинного обучения
Для BI процесс формирует согласованные показатели и таблицы, на которых строятся дашборды. Общие определения выручки, активного клиента и завершенного заказа устраняют расхождения между отчетами отделов.
При подготовке обучающих выборок важен момент появления каждого признака. Если модель получает сведения, которые возникли уже после прогнозируемого события, возникает утечка целевой переменной: тестовые результаты выглядят убедительно, но не отражают качество будущих прогнозов.
Сильные стороны и ограничения
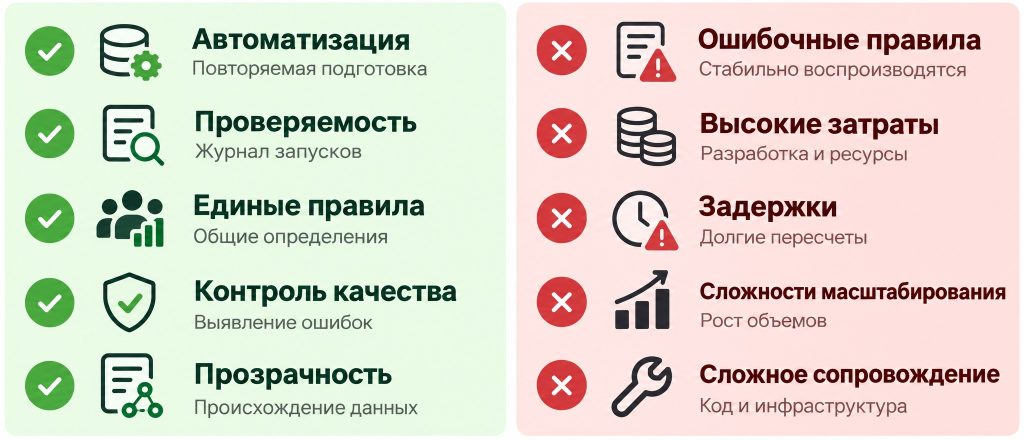
ETL делает подготовку информации повторяемой и проверяемой. Команда фиксирует правила в коде или настройках платформы, а журнал запусков помогает выяснить, почему изменился показатель.
Однако автоматизация сама по себе не гарантирует достоверность. Ошибочное бизнес-правило будет воспроизводиться так же стабильно, как корректное, поэтому технические проверки дополняют согласованием с владельцами показателей.
Качество, автоматизация и единые правила обработки
Общая работа аналитиков и разработчиков помогает закрепить единые определения метрик. Вместо нескольких независимых расчетов компания получает согласованный алгоритм, который проходит тестирование и контроль изменений.
Централизованные проверки выявляют пустые обязательные поля, нарушения связей и недопустимые значения. Они также показывают происхождение результата: команда видит, из каких записей и по каким правилам появился итоговый показатель.
Затраты на внедрение, задержки и сложности масштабирования
Расходы складываются из разработки, вычислительных ресурсов, хранения промежуточных копий и поддержки интеграций. При росте объемов прежние запросы могут перестать укладываться в допустимое время, а полные пересчеты начинают мешать ежедневным запускам.
Подходы к реализации могут отличаться по сложности сопровождения. Визуальный конструктор ускоряет создание типовых связей, но нестандартная логика требует кода и тестов; собственные скрипты дают гибкость, однако команда сама поддерживает их инфраструктуру.
Как внедрить процесс: от требований до запуска
Внедрение начинается с конкретного результата: например, отчет о продажах за вчера должен обновляться к девяти утра и учитывать возвраты. Такая формулировка задает проверяемые требования и помогает не усложнять проект заранее.
Первый запуск разумно ограничить небольшой, но завершенной задачей. Команда проверит весь путь от подключения до готового отчета, а затем расширит охват без догадок о поведении отдельных компонентов.
Определить цели, источники и требования
Первый шаг фиксирует состав показателей, частоту обновления и допустимые расхождения. Владелец отчета подтверждает правила расчета, а разработчики проверяют доступность нужных полей и глубину истории.
Техническое описание также определяет ключи записей, часовые пояса, единицы измерения и порядок учета исправлений задним числом. Эти детали влияют на результат сильнее, чем выбор языка программирования.
Выбрать ETL-инструменты и спроектировать преобразования
Команда оценивает ETL-инструменты по поддержке нужных подключений, объему нагрузки, возможностям тестирования и требованиям к размещению. Стоимость лицензии рассматривают вместе с расходами на сопровождение и квалификацию специалистов.
Проект описывает маршрут, правила сопоставления, расчетные поля и поведение при ошибках. Версионирование кода и конфигурации позволяет связать изменение показателей с конкретным обновлением логики.
Протестировать процесс, настроить расписание и запустить загрузку
Проверка на небольшом корректном файле не показывает, как цепочка поведет себя в реальных условиях. До запуска коллектив проверяет несколько групп сценариев:
- Корректность расчетов: итог совпадает с согласованными контрольными значениями.
- Пограничные случаи: пустые поля, повторы, возвраты и опоздавшие записи получают ожидаемый результат.
- Устойчивость: недоступность API или обрыв соединения не оставляют целевые таблицы в некорректном состоянии.
- Производительность: расчет завершается в отведенное время на ожидаемом объеме.
После тестов команда задает расписание, зависимости и ответственных за сбои. Первый промышленный запуск сопровождает сверка с проверенным отчетом или контрольной выборкой.
Как обеспечить надежность после запуска
После внедрения меняются форматы внешних систем, объемы и бизнес-правила. Поэтому основной критерий надежности состоит не в отсутствии ошибок, а в способности быстро их обнаружить и восстановить корректный результат.
Технически успешный запуск еще не подтверждает актуальность отчета. Задача может завершиться без исключений, хотя внешний сервис вернул пустой ответ или перестал присылать часть записей.
Проверки качества, мониторинг и уведомления об ошибках
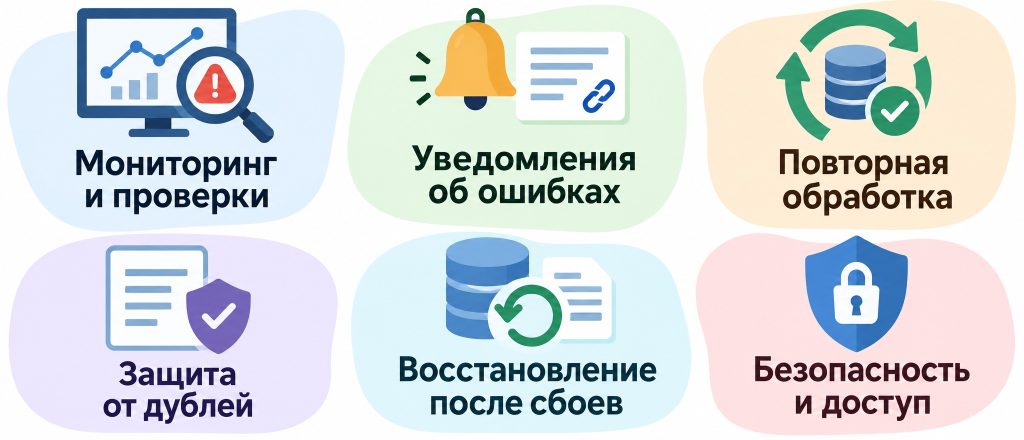
Мониторинг отслеживает длительность задач, число полученных строк, долю отклонений и время последнего обновления. Проверки сравнивают эти показатели с ожидаемыми границами и учитывают сезонность: выходной день не должен вызывать те же подозрения, что внезапное падение продаж в рабочий.
Уведомление помогает быстрее устранить сбой, если содержит название задачи, период, причину и ссылку на технический журнал. Инструкция заранее назначает ответственного и описывает порядок действий, чтобы оповещение не осталось просто сообщением в общем чате.
Повторная обработка, защита от дублей и восстановление после сбоев
Идемпотентность позволяет безопасно использовать повторный запуск: он приводит систему к тому же результату, а не создает дополнительные копии строк. Для этого разработчики применяют устойчивые ключи, обновление записей по идентификатору или замену конкретного временного раздела.
Контрольные точки фиксируют успешно пройденные участки, а сохраненные исходные выгрузки помогают пересчитать затронутый период. Атомарная публикация результата защищает пользователей от частично обновленного отчета: механизм открывает новую версию только после завершения всех обязательных проверок.
Безопасность и разграничение доступа
Каждое подключение получает только необходимые права, а пароли и токены хранятся в специальном сервисе секретов, не в коде. Шифрование при передаче и хранении снижает риск раскрытия информации, но не заменяет разграничение доступа.
Отдельного контроля требуют staging-слой, технические журналы и тестовые среды: они тоже могут содержать персональные сведения. Политика хранения задает сроки удаления копий, журнал аудита фиксирует обращения, а маскирование скрывает чувствительные значения там, где полные записи не нужны.
Разобравшись, что такое ETL (что это), начните с конкретной задачи: какой отчет нужен бизнесу, откуда поступают записи и как часто они должны обновляться. Для первого запуска выберите небольшой сценарий с понятными правилами расчета и проверяемым результатом. Оценивайте ETL-инструменты по поддержке нужных подключений, возможностям тестирования, стоимости сопровождения и навыкам команды. Не усложняйте архитектуру потоковым режимом, если ежедневное обновление закрывает потребность. Сразу предусмотрите контроль качества, защиту доступа и безопасный повторный запуск после сбоя. Такой подход поможет проверить пользу решения до масштабирования и избежать ситуации, когда автоматизация лишь быстрее воспроизводит ошибки.
Расскажите в комментариях, какую задачу вы планируете решить с помощью ETL и что вызывает вопросы.