


Что пишут в телеграм-канале
Официальный канал провайдера ожил почти сразу после первых жалоб. В сообщении от 20 ноября команда сообщает, что причины сбоя пока неизвестны, а инженеры занимаются ручной настройкой оборудования прямо в дата-центрах. Формулировка сухая, но за ней читается главное: автоматика не справилась, поэтому восстановление идет медленно и по шагам. Следить за апдейтами удобнее всего там же, в канале https://t.me/beget_official/571, потому что почта и личный кабинет в такие моменты тоже лежат.
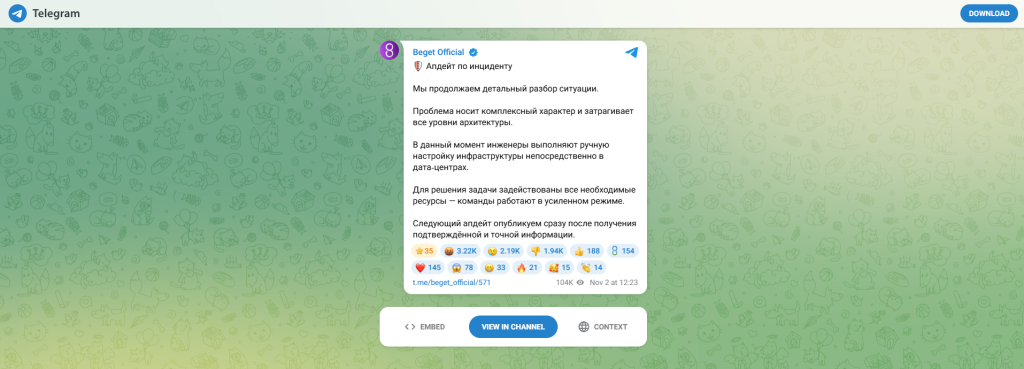
Картина масштабная. Пострадала вся цепочка: панель управления, файловые хранилища, база данных, DNS и почтовые ящики. Пользователь видит только белую страницу в браузере, а на деле сломано сразу несколько звеньев.
Отсюда и характерные симптомы: у одного проект открывается по старому кешу, у другого сайт не грузится совсем, третий ловит ошибку 502 на всех вкладках.
Почему один сбой роняет все сразу
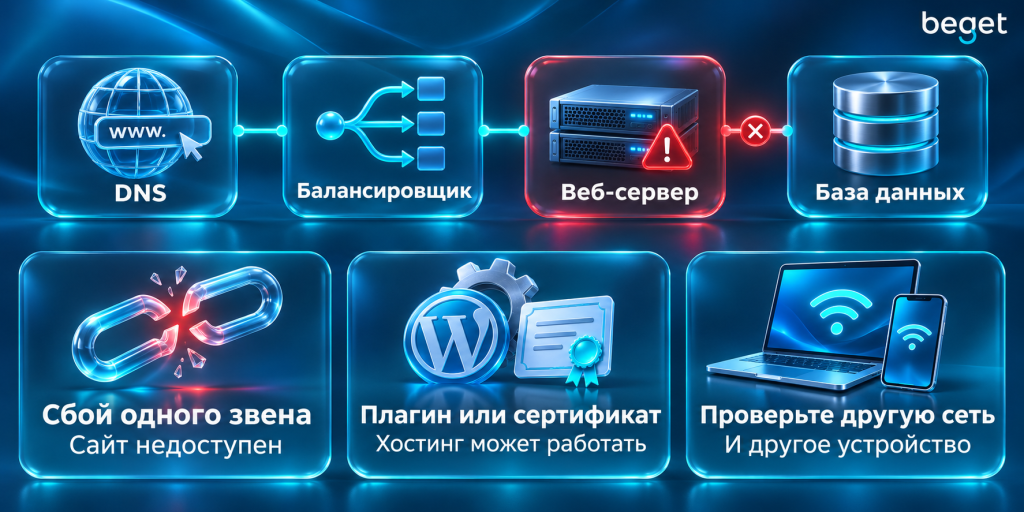
Хостинг устроен как матрешка. Сначала DNS, то есть телефонная книга интернета: он переводит адрес сайта в IP-адрес сервера. Дальше балансировщик, который распределяет запросы между машинами. Потом веб-сервер с файлами и база данных, где хранятся заказы, товары, комментарии. Любое звено выпадает, и картинка для посетителя одинаковая: пустота вместо контента.
Провайдер может быть полностью здоров, а тормозить будет плагин на WordPress или истекший сертификат. И наоборот: инфраструктура лежит целиком, а часть посетителей видит сайт из кеша и не понимает, о чем шум.
Отдельная история с Windows. Если доступ к панели или FTP пропал на домашнем компьютере, а на телефоне тот же адрес открывается нормально, проблема почти всегда локальная: кеш DNS, старые cookie, антивирус с фильтром трафика. Проверка с другого устройства и другой сети экономит нервы и не дает зря ругать провайдера.
Что делать прямо сейчас
Паника плохой советчик, а вот короткий порядок действий помогает не навредить себе же.
- Открыть официальный канал и прочитать последний пост. Если там уже пишут про сбой, остается ждать и не трогать настройки.
- Проверить сайт с мобильного интернета или через сервис проверки доступности. Так видно, лежит площадка целиком или только ваша сеть.
- Не менять DNS, не переустанавливать панель и не откатывать резервные копии в разгар аварии. Половина таких правок потом мешает восстановлению.
- Убедиться, что свежие бэкапы есть вне хостинга. Ночь аварии это не время искать, где лежит архив.
- Зафиксировать для себя таймлайн: когда упало, что уже пробовали. С поддержкой такой список обсуждать проще.
ТОП-5 решений, если Beget не работает в России в 2026 году
Ниже — набор площадок, которые стоит держать в уме, когда основной хостинг снова дает сбой. У каждой свои сильные стороны, и выбирать есть смысл по задаче: одним нужен полный стек услуг, другим важна поддержка, третьим — оплата по факту нагрузки.
- Timeweb — держит собственные дата-центры в России и закрывает почти весь стек: от виртуального хостинга и VPS до выделенных машин и регистрации доменов, поэтому при переезде не приходится собирать услуги у нескольких поставщиков.
- SmartApe — специализируется на сайтах под управлением CMS: тарифы собраны под WordPress и 1С-Битрикс, есть защита от DDoS и перенос проекта силами поддержки.
- WebHOST1 — работает на собственной серверной площадке в России и делает ставку на круглосуточную поддержку с быстрым откликом, что заметно при разборе аварий.
- Евробайт — один из старых игроков российского рынка хостинга, помимо виртуальных тарифов держит собственные стойки и дает доступ к серверным мощностям без посредников.
- Спринтхост — считает нагрузку по факту и предлагает тарифы с оплатой за реально израсходованные ресурсы, что удобно для проектов с неровным трафиком.
Когда пора собирать чемоданы, а когда еще рано
Перенос это не эмоциональный жест, а решение с ценой. Переезд на новую площадку занимает от нескольких часов до пары суток, тянет за собой даунтайм, переоформление DNS и риск потерять письма. Поэтому сначала стоит понять, с чем именно пришлось столкнуться.
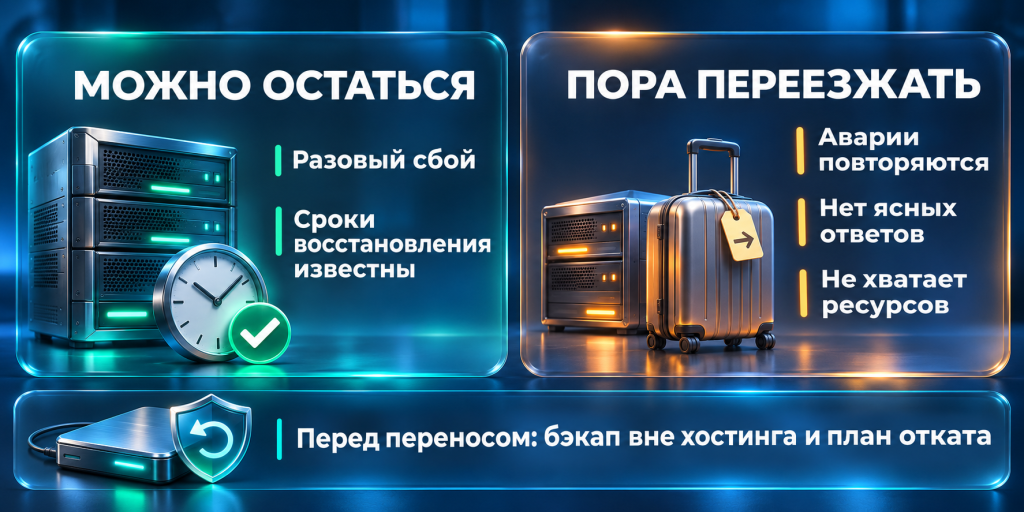
Оправдан переезд, если аварии повторяются. Один масштабный сбой в ноябрьскую ночь пережить можно, а вот серия падений за пару месяцев это уже сигнал. Сюда же относится история, когда провайдер не публикует внятных сроков и молчит в официальных каналах, оставляя пользователя гадать, случилось что-то с его аккаунтом или легла вся площадка.
Есть и технические поводы. Если проект перерос тариф и упирается в лимиты по памяти или диску, а апгрейд упирается в отсутствие нужной конфигурации, проще сменить площадку, чем годами жить на потолке. Тот же вывод напрашивается, когда нужна специфика: выделенный сервер с собственным ядром, размещение в конкретном регионе или поддержка редкого стека.
Обратная ситуация тоже бывает. Разовая авария, о которой команда честно сообщает в канале и которую чинят на глазах, это не причина ломать отлаженную инфраструктуру. Перенос в панике, посреди восстановления, почти всегда заканчивается вторым переездом через месяц и потерей данных на стыке.
- Держаться за текущий хостинг стоит, если сбой единичный и сроки работ озвучены.
- Двигаться дальше имеет смысл при повторяющихся авариях и слабой коммуникации.
- Перед любым переездом нужен свежий бэкап вне площадки и план отката.
Простой тест: если мысль о следующем падении вызывает больше тревоги, чем сам переезд, значит пора готовить архив и присматривать новый сервер.
Пока сервер молчит, робот поисковика продолжает стучаться
Сбой бьет не только по посетителям. Поисковый робот, то есть программа, которая обходит сайт и складывает страницы в индекс, приходит по расписанию и не знает про аварии. Он получает пустой ответ или ошибку 5xx и делает вывод: контент недоступен. Индекс, база найденных страниц, постепенно начинает терять позиции по этим адресам.
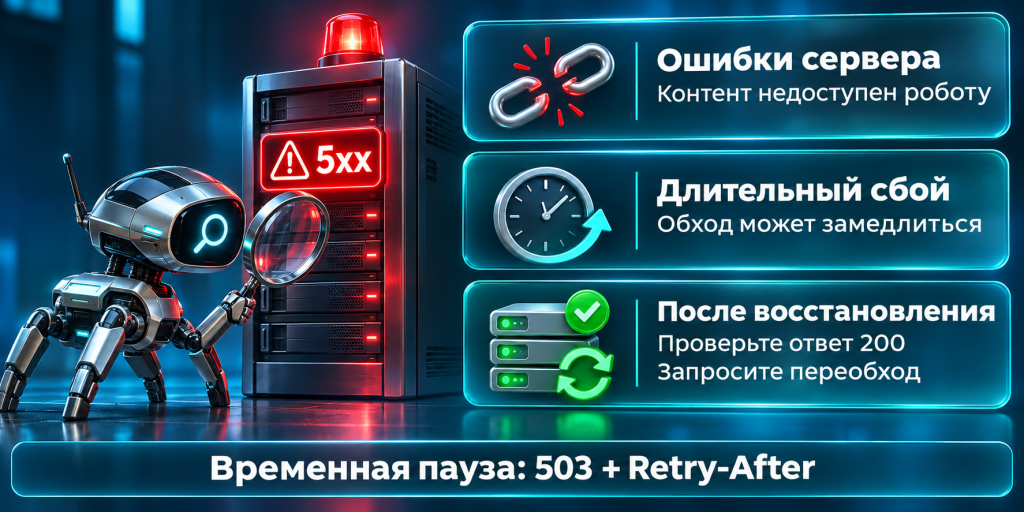
Дальше включается механика краулингового бюджета. Так называют лимит запросов, который поисковик выделяет на конкретный сайт. Чем больше ошибок робот видит, тем реже он заходит, и после восстановления свежие материалы ждут обхода неделями. Google и Яндекс ведут себя похоже, но с разной скоростью: первый осторожнее, второй реагирует заметнее на поведенческие сигналы.
Отдельная беда: часть страниц выпадает из выдачи, а часть остается, но с пометкой о недоступности. Возврат в топ потом идет не автоматически. Каждому адресу снова нужен успешный ответ 200, обновленный кеш и хоть какие-то переходы, чтобы алгоритм убедился: сайт жив, и старый контент никуда не делся.
- Короткий сбой на пару часов поисковики почти не замечают, робот просто вернется позже.
- Провал на сутки и дольше снижает частоту обхода, и это ощущается еще месяц.
- Ответ 503 с заголовком Retry-After дает роботу понять, что пауза временная, и сохраняет позиции мягче.
- Ошибка 502 без пояснений выглядит как поломка, поэтому доверие к домену падает быстрее.
Практический вывод простой. Пока идет восстановление, стоит поднять на стороне сервера аккуратную заглушку с кодом 503, а в панели вебмастера потом запросить переобход ключевых разделов.
Российские вебмастера часто пропускают этот шаг и удивляются просадке трафика через две недели после аварии.
Как подготовиться к следующему сбою: шесть шагов, которые закрывают заранее
Авария на стороне провайдера редко оказывается последней. Площадки меняют оборудование, перекраивают сеть, отбивают атаки, и каждая процедура несет риск простоя. Подготовка не требует крупных затрат, зато сокращает окно недоступности с суток до часов. Ниже шесть шагов, которые разумно закрыть до того, как сбой повторится.
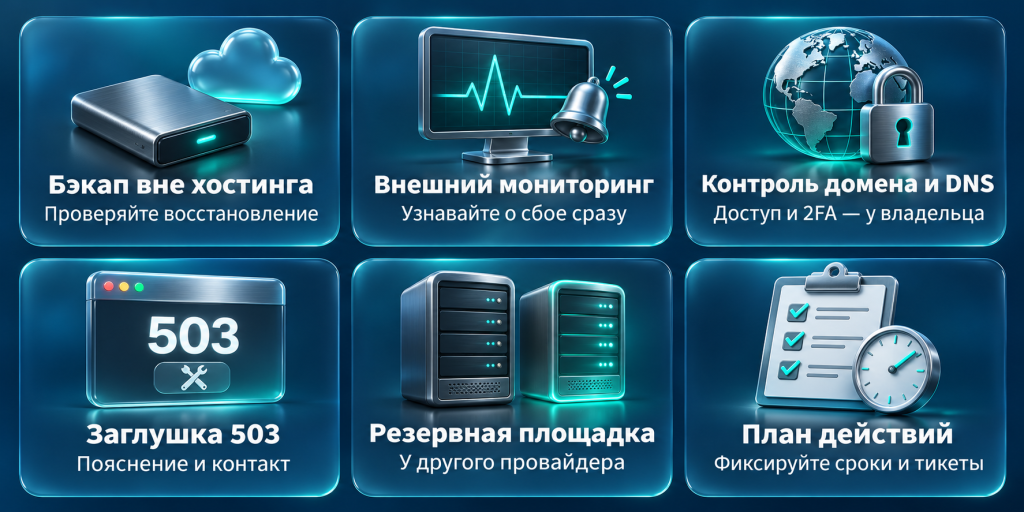
Копии данных за пределами площадки
Резервная копия, или бэкап, это архив файлов и базы данных, из которого поднимают проект после потери. Держать ее на том же сервере бессмысленно: при отказе диска исчезнет и сайт, и архив. Рабочая схема включает две точки хранения: локальную копию у себя и удаленную у другого поставщика. Частоту задает динамика проекта, для блога хватает ежедневного снимка, интернет-магазину нужен интервал в несколько часов. Отдельно проверяют восстановление: архив, который ни разу не разворачивали, считается непроверенным.
Независимый мониторинг доступности
Uptime-робот это внешний сервис, который запрашивает страницу каждые несколько минут и сообщает об ошибке. Такой мониторинг дает картину со стороны, и письмо о падении приходит раньше официального сообщения в канале. Проверять стоит не только главную, но и формы заказа, личный кабинет, админку. Порог оповещения выставляют на две-три минуты, чтобы короткие перезапуски не поднимали тревогу зря.
Контроль домена и DNS
DNS это система, которая переводит адрес сайта в IP-адрес сервера. Запись TTL указывает, сколько времени кеш держит старое значение, и понижение этого параметра до пяти минут за сутки до плановых работ ускоряет переключение. Доступ к панели регистратора держат на своем аккаунте с двухфакторной аутентификацией. Права на домен остаются у владельца, а не у подрядчика: соблюсти это условие сразу дешевле, чем выкупать имя обратно.
Понятная заглушка вместо белого экрана
Пока идет восстановление, посетитель должен видеть объяснение, а не пустую страницу. Браузер в этом случае получает заглушку с кодом 503 и заголовком Retry-After, а поисковый робот понимает, что пауза временная. Текст на такой странице содержит короткое пояснение и контакт для срочных вопросов. Заодно это снимает часть нагрузки на поддержку: типовой вопрос закрывается без обращения.
Резервная площадка на низком старте
Холодный резерв это аккаунт у второго хостинга с оплаченным минимальным тарифом, куда переносят проект при повторной аварии. Полноценная инфраструктура там не нужна, достаточно места под архив и заранее созданной конфигурации. Важно, чтобы площадка находилась в другой сети и у другой компании, иначе общий сбой у поставщика связи уронит оба варианта. Стоимость такого резерва обычно ниже, чем потери от лишних суток простоя.
Регламент действий и фиксация сроков
Список очередности действий снимает споры в момент паники: сначала проверка доступности с другого устройства и сети, затем официальный канал, потом обращение в поддержку с описанием симптомов. Каждое обращение стоит фиксировать с временем отправки и номером тикета, это пригодится при разговоре о компенсации. Отдельный пункт регламента касается локальных причин: кеш и настройки на Windows у конкретного сотрудника не должны выглядеть как отказ хостинга. Проверка с телефона за пару минут отделяет проблему пользователя от проблемы площадки.
Перечисленные шаги не отменяют аварию, но меняют ее последствия. Простой в несколько часов с понятной заглушкой и свежим архивом проходит почти незаметно для трафика. Тот же простой без копий и без плана превращается в многодневное восстановление с потерей позиций и заявок.
Вопросы, которые задают чаще всего
За несколько разборов похожих историй собрался набор ситуаций, которые повторяются почти в каждой аварии. Ниже короткие ответы на них. Если вы уже пережили ночной сбой, этот список сэкономит время следующей ночью и убережет от лишних тикетов в поддержку.
Сайт открывается у коллег, а у меня нет. Бегет не работает или дело в моей сети?
Скорее второе, и это самый частый случай. Проверьте адрес с телефона на мобильном интернете: если страница подгружается, значит площадка жива, а проблема сидит на вашей стороне. Дальше по очереди: кеш браузера, старые записи DNS, фильтр трафика в антивирусе на Windows. Все эти штуки умеют держать устаревшую копию страницы и показывать ее вместо живой.
Страница не грузится, но панель управления отвечает. Это один сбой?
Не обязательно, хотя связано бывает часто. Панель, файловое хранилище и база данных это разные узлы, и падение одного не всегда роняет остальные. Так происходить может при перегрузке диска или при работах на конкретном сегменте сети. Ориентируйтесь на симптомы: панель жива, а контент нет, значит смотреть стоит в сторону базы и файлов.
Что делать, если сайт не открывается и в официальном канале пока тишина?
Сначала убедитесь, что проблема не локальная, затем откройте канал провайдера и обновите его через десять минут. Параллельно отправьте обращение в поддержку с описанием симптомов и точным временем начала. Номер тикета и время отправки пригодятся позже, когда речь зайдет о компенсации за простой.
Какая причина обычно стоит за ошибкой 502?
Код 502 означает, что внешний сервер не дождался ответа от внутреннего. На практике это перегруженный обработчик PHP, упавший процесс или зависший запрос к базе. Иногда виноват плагин, который тянет память сверх лимита тарифа. Отличить одно от другого помогает лог ошибок: он показывает, на каком именно шаге обрывается цепочка.
Сайт упал ночью, а к утру поднялся сам. Нужно ли что-то предпринимать?
Проверьте целостность данных и свежесть бэкапа, этого обычно достаточно. Короткий простой почти не влияет на выдачу, робот вернется по расписанию. А вот если падения повторяются с завидной регулярностью, стоит задуматься о резервной площадке, о ней мы говорили выше.
Сайт не прогружается до конца: шапка на месте, а товаров нет. Это авария?
Похоже на сбой одного из компонентов, а не всего сервера. Шапка отдается из кеша, а товары подтягиваются запросом к базе, и вот он как раз может висеть. Попробуйте обновить страницу с очищенным кешем и проверьте раздел с каталогом в другом браузере. Если картина повторяется, передайте в поддержку точный адрес страницы и время запроса.
Beget не работает вторые сутки. Когда уже пора переезжать?
Сутки это граница, после которой стоит включить план Б. Поднимите проект из свежего архива на резервной площадке, если он у вас есть, или хотя бы подготовьте перенос. Решение о постоянном переезде принимают позже, когда появятся данные о сроках восстановления и о том, насколько честно компания освещала ситуацию.
Начинать стоит с проверки доступности с другого устройства и сети, затем открыть официальный канал и убедиться, что сбой не локальный: кеш браузера и записи DNS на Windows дают похожую картину. Если Beget не работает вторые сутки, разумно поднять проект из свежего архива на резервной площадке, а решение о переезде принимать по частоте аварий и качеству коммуникации. При выборе нового провайдера смотрят на собственные дата-центры, прозрачные сроки восстановления, наличие бэкапов вне площадки и скорость поддержки. Для магазина важнее круглосуточный мониторинг и защита от атак, для блога хватит простого тарифа с честными лимитами.
Истории про конкретные аварии и способы выхода из них полезнее любых общих советов, поэтому опытом стоит делиться: что помогло, сколько длился простой, как повела себя поддержка.



Когда Бегет лёг, я первым делом полез менять DNS, хотя во время общей аварии этого как раз делать не стоит. После этой истории точно буду хранить свежую копию сайта отдельно от хостинга.